
Claude Opus 5.5 obtiene una puntuación superior a Gemini 4 Argon en los datos del Artificial Analysis Intelligence Index del 5 de octubre de 2026 y lidera tres de las cuatro evaluaciones detalladas de esta comparación. Argon lidera AutomationBench-AA y tiene el menor coste estimado por tarea. Es una diferencia medible, pero no demuestra que uno de los modelos sea el mejor para una especialidad de software concreta.
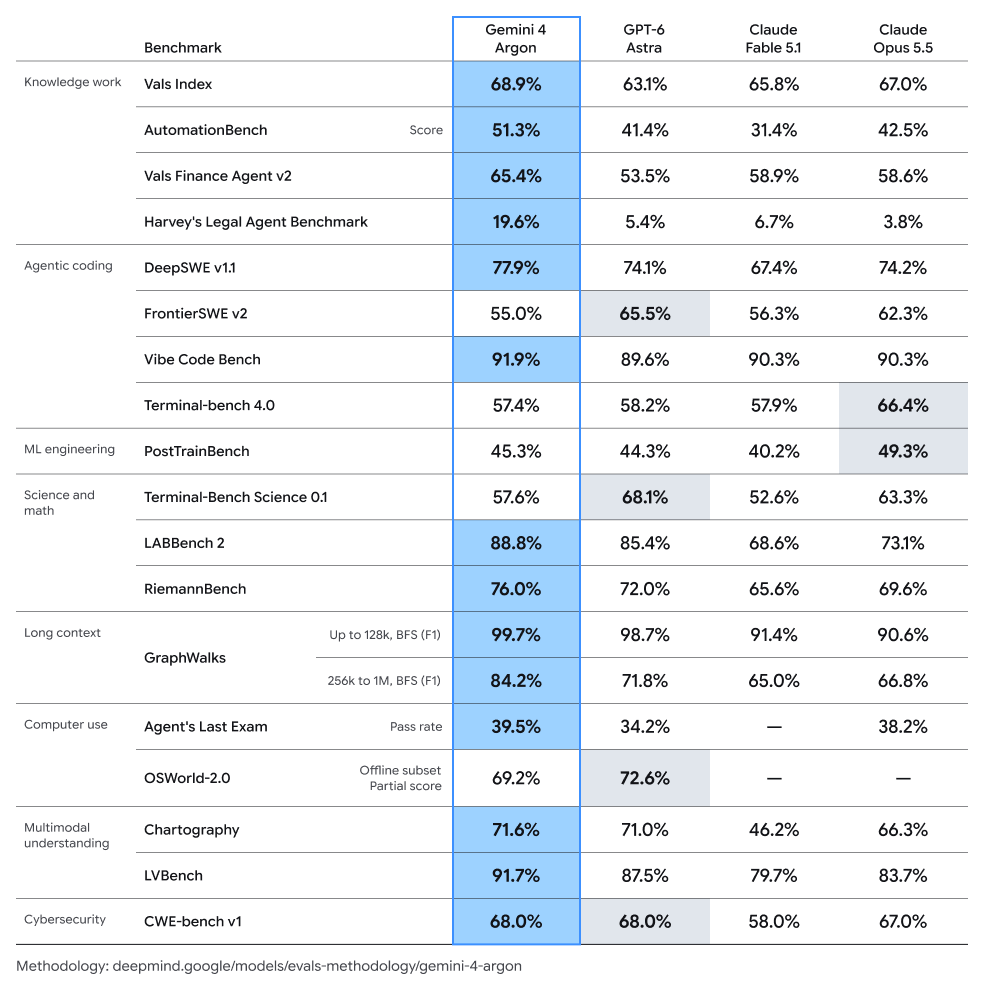
Fuente: Sundar Pichai, 30 de septiembre de 2026. En esta tabla de Google, Terminal-bench 4.0 registra 57,4 % para Argon y 66,4 % para Opus 5.5, y la celda de Opus aparece sombreada. Astra obtiene 58,2 % y Fable 5.1, 57,9 % en esa fila. Esos porcentajes no son las cifras de Terminal-Bench 4.0 de Artificial Analysis que aparecen en la tabla siguiente, donde son 57 % y 60 %.
Argon High frente a Opus 5.5 de un vistazo
La comparación de Artificial Analysis evalúa Gemini 4 Argon High frente a Claude Opus 5.5 Max, Default Fallback. Las cifras corresponden a los datos publicados el 5 de octubre de 2026.
| Evaluación | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 58 |
| Coste estimado por tarea | $1.99 | $5.98 |
| AutomationBench-AA | 78% | 70% |
| Terminal-Bench 4.0 | 57% | 60% |
| GDP.pdf | 22% | 26% |
| AA-LCR v1.1 | 80% | 85% |
Opus lidera el índice por 5 puntos, Terminal-Bench 4.0 por 3 puntos, GDP.pdf por 4 puntos y AA-LCR v1.1 por 5 puntos. Argon lidera AutomationBench-AA por 8 puntos. En estos datos, la estimación por tarea es de $1.99 para Argon y $5.98 para Opus.
Cómo interpretar la diferencia de adecuación a cada tarea
La tabla sugiere un punto de partida para las pruebas:
- Asigna Argon a un flujo de trabajo con mucha automatización si el resultado del 78% en AutomationBench-AA refleja las acciones que necesita tu sistema.
- Asigna Opus a un flujo en el que importen la ejecución en terminal, el razonamiento sobre documentos o la familia de tareas AA-LCR, y sus puntuaciones más altas compensen el coste adicional.
- Mide el trabajo completado con tus propios prompts. Una puntuación de benchmark no establece un ganador universal para la programación diaria, el trabajo de interfaces o la redacción larga.
Las configuraciones evaluadas no justifican asignar a estos modelos una identidad frontend o backend. El acceso a herramientas, el contexto, las pruebas y el comportamiento de reintento pueden cambiar el resultado práctico.
Las tarifas por token son independientes del coste por tarea
La misma comparación de Artificial Analysis muestra estas tarifas para las configuraciones evaluadas:
| Concepto de precio | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Entrada / salida por 1M tokens | $2 / $10 | $4 / $20 |
| Entrada en caché por 1M tokens | $0.10 | $0.20 |
Las cifras por tarea son costes de evaluación ponderados, no tarifas fijas que todos los clientes paguen por cada solicitud. Una ejecución en producción puede tener una mezcla de tokens, una ruta de herramientas y una longitud de respuesta diferentes. Usa la tarjeta de tarifas para presupuestar y un conjunto de tareas representativo para calcular la economía unitaria.
La disponibilidad también forma parte de la comparación
El anuncio de Google del 30 de septiembre dice que Argon se ofrece inicialmente a defensores cibernéticos de confianza mediante Fairwind y se usa internamente, mientras que la ampliación comienza con clientes de API de pago y suscriptores de Google AI Ultra. El anuncio no promete una fecha de lanzamiento para todas las cuentas. Consulta los detalles de acceso a Argon antes de comparar un modelo al que puedes llamar con otro que quizá siga restringido.
Lecturas relacionadas
Prueba Gemma 4 online
~/gemma4 $ Prueba Gemma 4 en el navegador antes de instalarlo en tu equipo.
Probar Gemma 4 />


