
“基准刷分”(benchmaxxing)是一个有争议的说法,用来描述基准测试成绩与日常编程之间可能存在的差距。截至 2026 年 10 月 5 日,现有证据支持一个更谨慎的结论:Gemini 4 Argon 有很强的公开成绩,但这些成绩不能说明它在每个真实代码仓库或界面任务中的表现。
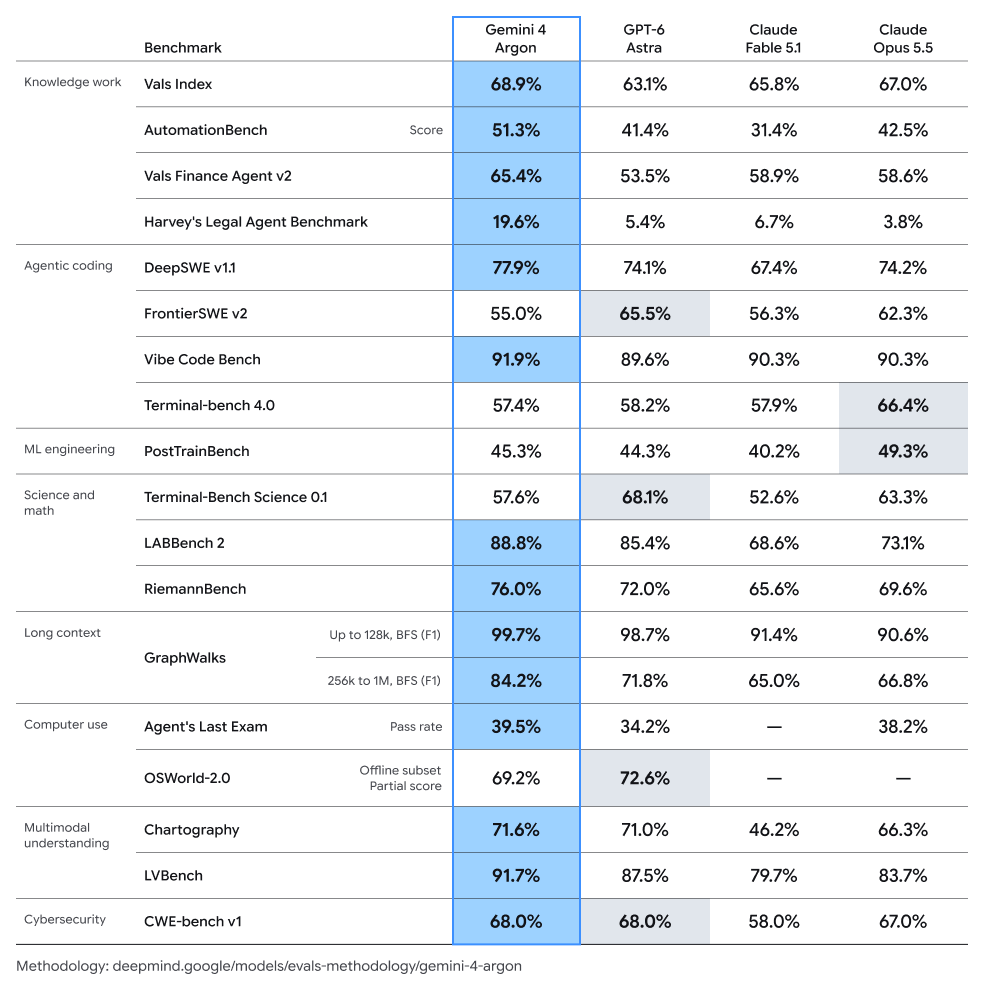
来源:Sundar Pichai,2026 年 9 月 30 日。阴影单元格表示另一模型在该项基准测试中领先。FrontierSWE v2 中 Astra 为 65.5%、Argon 为 55.0%;Terminal-bench 4.0 中 Opus 5.5 为 66.4%、Argon 为 57.4%。同一表格中的 DeepSWE v1.1 为 Argon 的 77.9%。下一张表中的 Artificial Analysis 数字为 57%,来源不同,不是这里的 57.4% 单元格。
三份基准记录,三个不同问题
这些结果应当分开看,因为它们测量的任务不同,来源也不同。
| 来源与评测 | Argon 成绩 | 测量内容 |
|---|---|---|
| Google 公告:DeepSWE v1.1 | 77.9% | Google 的长时程软件工程成绩 |
| Artificial Analysis 模型记录:Terminal-Bench 4.0 | 57% | AA Intelligence Index 评测集中的一项 |
| FrontierSWE V2 榜单:proximus harness | 55.0% mean@5 | 34 个任务、每项 5 次试验、20 小时预算 |
在同一套主榜设置下,FrontierSWE 页面还报告 GPT-6 Astra 为 65.5%,Claude Opus 5.5 为 62.3%。它的成绩是 mean@5;须线表示最差和最好试验结果,并非置信区间。FrontierSWE 与 Google 的 DeepSWE v1.1、Artificial Analysis 的 Terminal-Bench 4.0 是不同评测。
这些成绩能说明什么,不能说明什么?
实际结论是:这些指标都不是日常编程排行榜。它们不能回答模型有多常保留现有 UI、避免回归、从工具调用失败中恢复,或让代码仓库最终通过测试。在某项基准上更高,完全可能与另一类任务中令人沮丧的工作流并存。
现有主要来源也没有证明 Argon 是在测试集上训练的,因此这种猜测无法解决代码能力问题。
如何公平测试 Argon 的真实工作流?
当 Argon 对你的工作负载开放后,可以建立一套固定评测集,反映你实际要做的工作:
- 选择没有出现在提示示例中的仓库和任务,先记录基线测试与构建结果。
- 纳入需要视觉检查、键盘和指针行为、响应式状态及无障碍检查的界面改动,不要只靠检查生成代码来判断。
- 每次改动后运行完整回归测试,记录新增失败、修复和回滚。
- 注入真实的工具失败或缺失上下文,测量模型能否在不做危险编辑、不反复陷入死循环的情况下恢复。
- 除通过率外,同时记录输入 Token、输出 Token、工具调用、耗时、重试次数和审阅者修正。
这份清单能把“代码写得好吗?”转化为可观察的结果,也让团队可以在同一批工作上比较 Argon、Astra、Opus 或 Sol,而不是把无关的基准百分比当成同一个指标。
实际上应如何使用“基准刷分”这个词?
把它用作一个关于“基准能否迁移到工作流”的问题,而不是对 Argon 的训练方式或诚实程度下结论。证据支持报告基准、配置和局限。要称得上日常编程赢家,需要来自读者关心的工作负载、可重复的任务结果。


