
Gemini 4 Argon tidak memiliki satu peringkat benchmark. Tabel peluncuran Google, catatan model Artificial Analysis, dan leaderboard FrontierSWE V2 mengukur tugas yang berbeda serta memberikan jenis bukti yang berbeda. Skor di bawah ini dipisahkan agar hasil pada satu evaluasi tidak dianggap sebagai kemenangan di semua evaluasi.
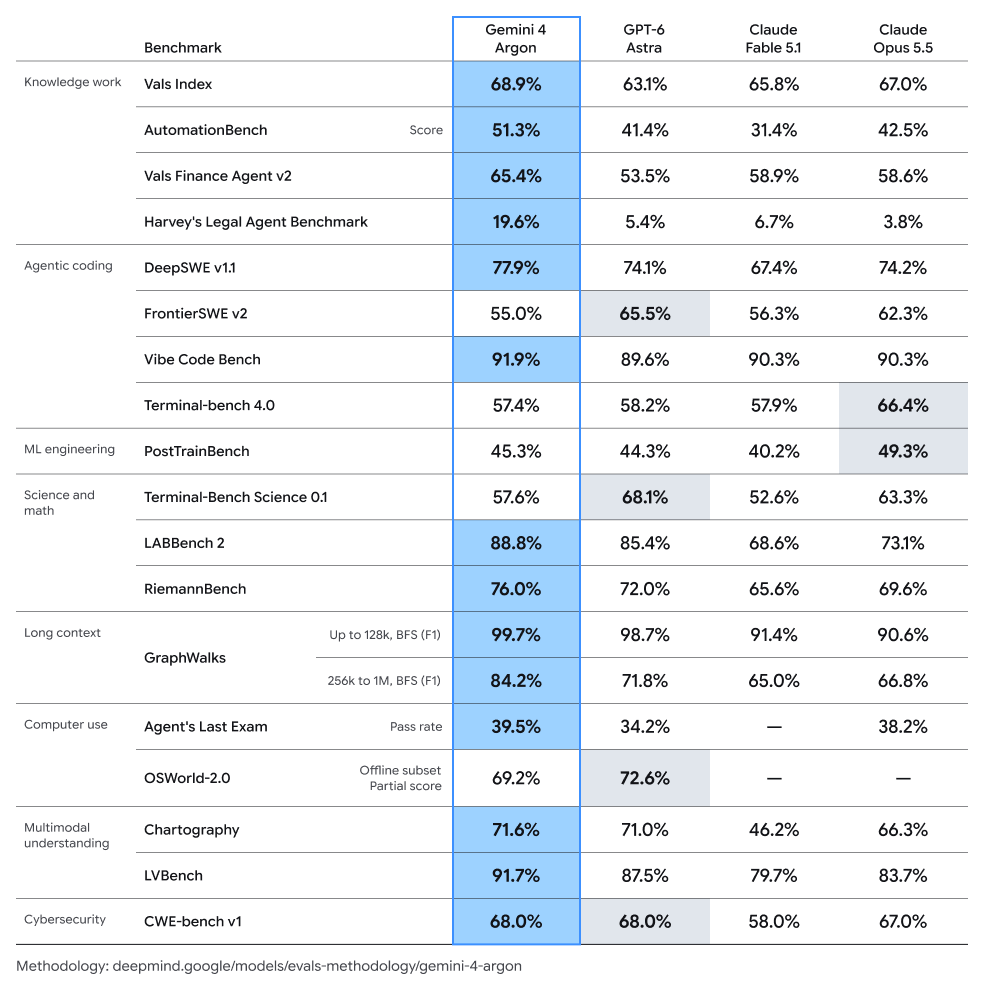
Sumber: Sundar Pichai, 30 September 2026. Ini adalah tabel perbandingan peluncuran Google. Sel yang diberi arsiran menandai baris saat model lain memimpin. Baris metodologi pada gambar mencantumkan deepmind.google/models/evals-methodology/gemini-4-argon.
Skor dalam tabel Google tanggal 30 September
Pengumuman Google melaporkan skor berikut:
| Evaluasi | Skor Argon | Klaim dalam post Google |
|---|---|---|
| DeepSWE v1.1 | 77.9% | State of the art baru untuk software engineering jangka panjang |
| AutomationBench (Zapier) | 51.3% | Peringkat pertama dalam eksekusi tugas bisnis end-to-end |
| LVBench | 91.7% | State of the art untuk pemahaman video berdurasi panjang |
| CWE-bench v1 | 68% | Seri pertama dalam memperbaiki kerentanan keamanan |
Artikel pengumuman menyoroti empat baris tersebut. Tabel yang diposting memuat rangkaian hasil yang lebih luas dari peluncuran yang sama. Pada gambar itu, Vals Index untuk Argon adalah 68.9% dan Harvey’s Legal Agent Benchmark 19.6%. FrontierSWE v2 mencatat 55.0% untuk Argon dan 65.5% untuk Astra, dengan sel Astra diberi arsiran. Terminal-bench 4.0 mencatat 57.4% untuk Argon dan 66.4% untuk Opus 5.5, dengan sel Opus diberi arsiran. Angka-angka ini dibaca dari gambar di atas; ini bukan kumpulan skor kedua yang ditambahkan ke halaman ini.
Snapshot Artificial Analysis
Catatan model Artificial Analysis yang diperiksa pada 5 Oktober 2026 melaporkan ringkasan terpisah:
| Field Artificial Analysis | Snapshot |
|---|---|
| Intelligence Index v4.3.2 | 53 (nilai dasar 52.5606) |
| Biaya per tugas Intelligence Index | Sekitar $1.99 |
| Context window | 1M token |
| Status akses | Belum tersedia untuk publik |
Intelligence Index adalah evaluasi gabungan, jadi angka 53 yang sudah dibulatkan tidak boleh digabungkan dengan persentase tugas spesifik dari Google. Biaya per tugas adalah estimasi evaluasi, bukan tagihan tetap bagi pelanggan. Lihat harga API dan batas output untuk harga token.
FrontierSWE V2: leaderboard coding dari sumber primer
Leaderboard FrontierSWE V2 melaporkan hasil coding yang berbeda. Tabel utamanya menggunakan harness proximus, seluruh 34 tugas, lima percobaan per tugas, dan anggaran 20 jam. Skornya adalah mean@5; whisker menunjukkan worst@5 sampai best@5 dan bukan confidence interval.
| Model | FrontierSWE V2 mean@5 |
|---|---|
| Gemini 4 Argon | 55.0% |
| GPT-6 Astra | 65.5% |
| Claude Opus 5.5 | 62.3% |
Dengan konfigurasi ini, Astra unggul 10.5 poin persentase dari Argon. FrontierSWE bukan DeepSWE dan bukan Artificial Analysis Terminal-Bench 4.0. Karena itu, tabel ini tidak mengubah hasil DeepSWE Google dan tidak menetapkan peringkat coding yang universal.
Grafik Text Arena dari pihak ketiga
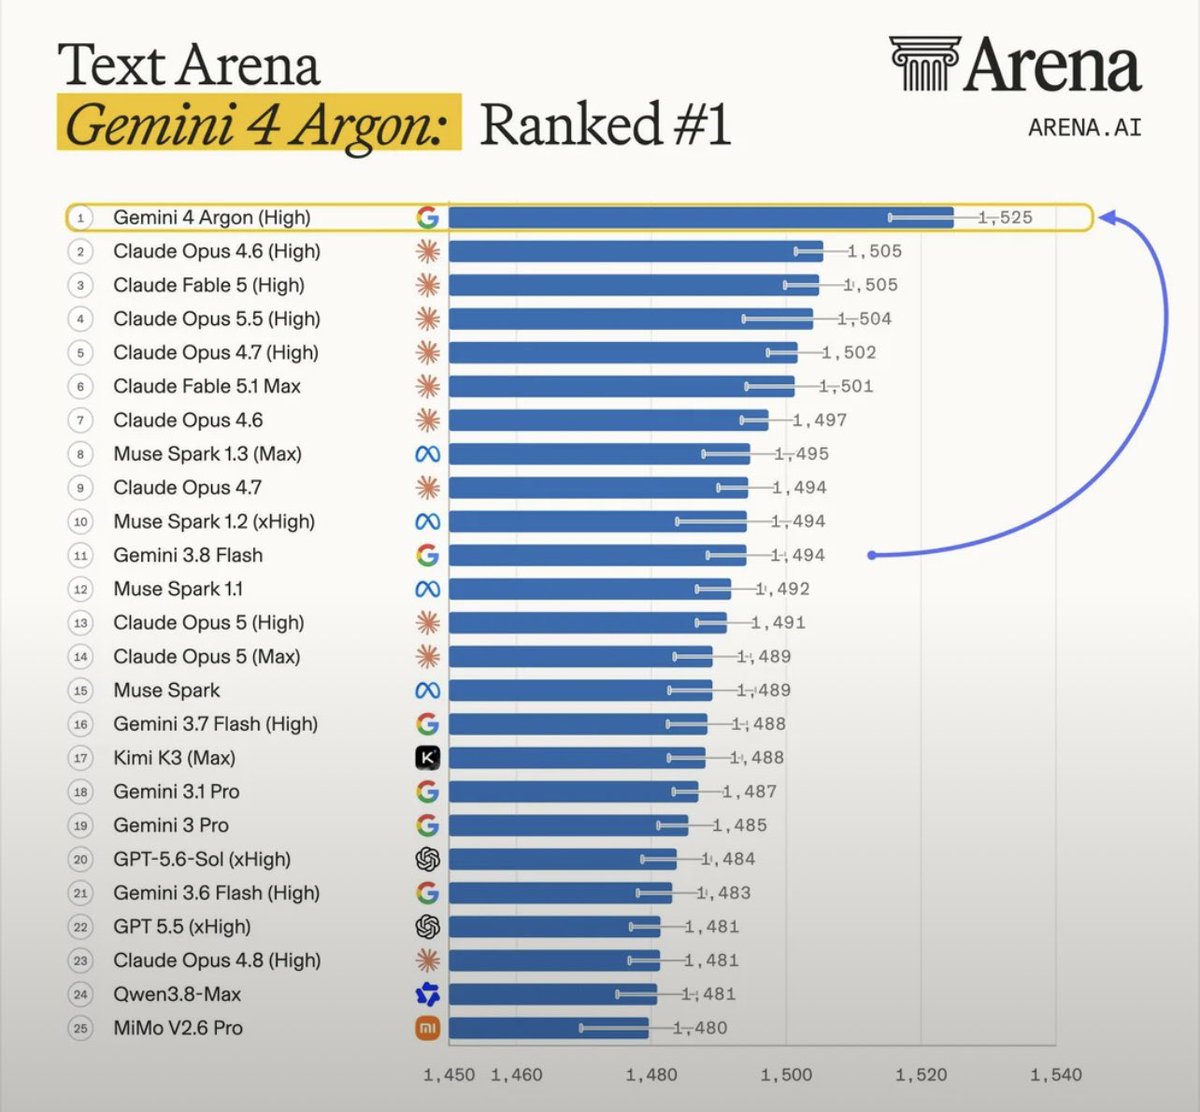
Sumber: @AI_Screening. Ini adalah grafik dari akun tersebut, bukan ekspor dari arena.ai, dan bukan salah satu dari tiga sumber pada tabel di atas. Grafik itu memberi label Gemini 4 Argon (High) dengan Elo 1,525 dan peringkat 1. Batang kedua adalah Claude Opus 4.6, bukan Opus 5.5. Bacalah sebagai gambar leaderboard preferensi dari post tersebut.
Cara membaca selisihnya
Kesimpulan yang berguna lebih sempit daripada “Argon menang di semua hal”. Hasil Argon bergantung pada tugas, harness, konfigurasi model, dan aturan penilaian. Untuk angka AA-Omniscience 15.1% yang terpisah, baca apa yang diukur tingkat halusinasi. Untuk perbedaan Argon dan Gemma 4, lihat perbandingan Gemma 4 dan Gemini.
Coba Gemma 4 secara online
~/gemma4 $ Coba Gemma 4 di browser sebelum memasangnya di perangkat Anda.
Buka playground Gemma 4 />


