
“Benchmaxxing” adalah istilah yang diperdebatkan untuk kemungkinan jarak antara performa benchmark dan coding sehari-hari. Bukti yang tersedia per 5 Oktober 2026 mendukung kesimpulan yang lebih terbatas: Gemini 4 Argon memiliki hasil publik yang kuat, tetapi hasil tersebut tidak membuktikan performanya di setiap repository atau antarmuka nyata.
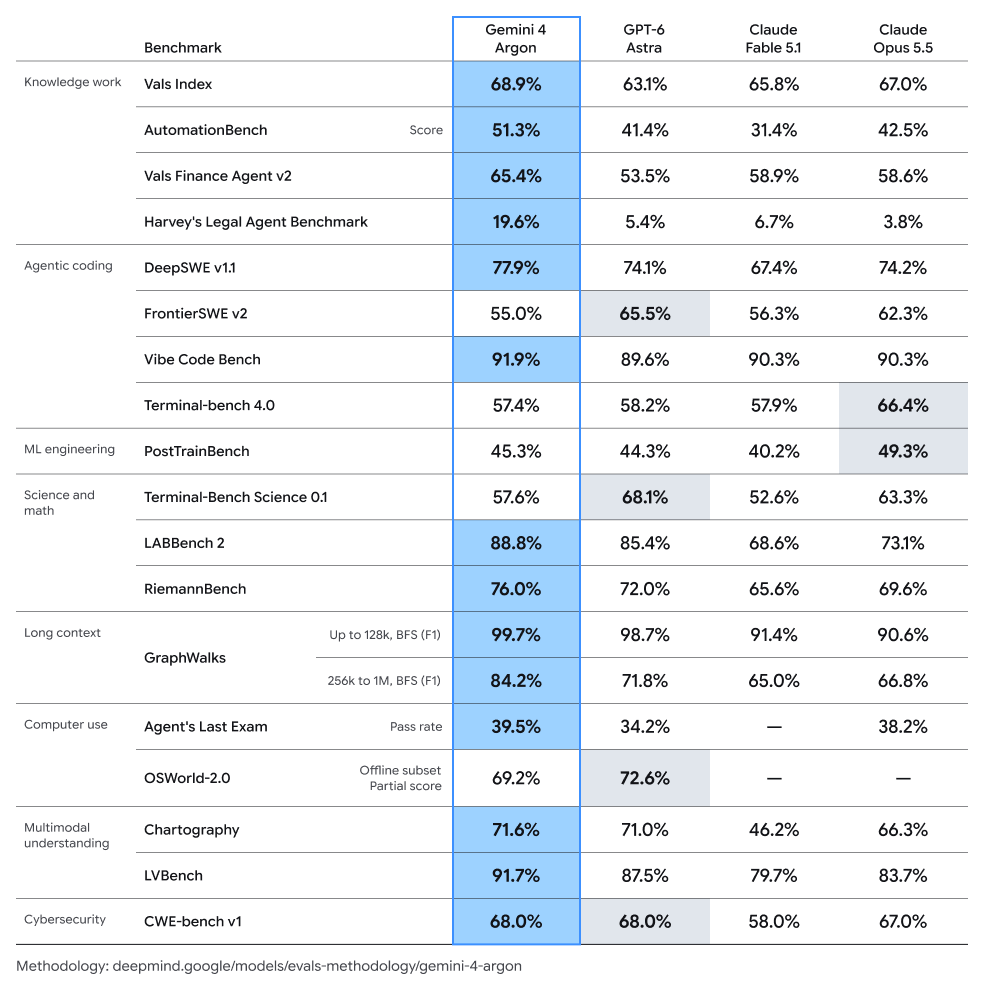
Sumber: Sundar Pichai, 30 September 2026. Sel yang diberi arsiran menunjukkan benchmark saat model lain memimpin. FrontierSWE v2 mencatat Astra 65.5% dan Argon 55.0%. Terminal-bench 4.0 mencatat Opus 5.5 66.4% dan Argon 57.4%. DeepSWE v1.1 pada tabel yang sama mencatat Argon 77.9%. Angka Artificial Analysis 57% pada tabel berikut dilaporkan secara terpisah; angka itu bukan sel 57.4% ini.
Tiga catatan benchmark, tiga pertanyaan berbeda
Hasil ini perlu dipisahkan karena mengukur tugas yang berbeda dan berasal dari sumber yang berbeda.
| Sumber dan evaluasi | Hasil Argon | Yang diukur |
|---|---|---|
| Pengumuman Google, DeepSWE v1.1 | 77.9% | Hasil software engineering jangka panjang versi Google |
| Catatan model Artificial Analysis, Terminal-Bench 4.0 | 57% | Salah satu komponen set evaluasi AA Intelligence Index |
| Leaderboard FrontierSWE V2, harness proximus | 55.0% mean@5 | 34 tugas, lima percobaan per tugas, anggaran 20 jam |
Halaman FrontierSWE juga melaporkan 65.5% untuk GPT-6 Astra dan 62.3% untuk Claude Opus 5.5 dengan konfigurasi utama yang sama. Skornya adalah mean@5; whisker menunjukkan hasil percobaan terburuk dan terbaik, bukan confidence interval. FrontierSWE terpisah dari DeepSWE v1.1 Google dan Terminal-Bench 4.0 Artificial Analysis.
Apa yang dibuktikan dan tidak dibuktikan oleh skor ini?
Kesimpulan praktisnya: tidak satu pun pengukuran ini merupakan leaderboard coding harian. Angka-angka tersebut tidak menjawab seberapa sering model mempertahankan UI yang ada, menghindari regresi, memulihkan tool call yang gagal, atau meninggalkan repository dengan tes yang tetap lulus. Hasil lebih tinggi di satu benchmark bisa berdampingan dengan workflow yang menyulitkan pada tugas lain.
Sumber primer yang tersedia juga tidak membuktikan bahwa Argon dilatih menggunakan test set. Spekulasi itu tidak bisa menyelesaikan pertanyaan tentang coding.
Cara menguji Argon pada workflow nyata secara adil
Saat Argon tersedia untuk workload-mu, gunakan set evaluasi tetap yang mencerminkan pekerjaanmu:
- Mulai dari repository dan tugas yang tidak digunakan dalam contoh prompt, lalu catat hasil tes dan build sebagai baseline.
- Sertakan perubahan antarmuka yang membutuhkan pemeriksaan visual, perilaku keyboard dan pointer, state responsif, serta pemeriksaan aksesibilitas; jangan menilai kode hanya dari inspeksi.
- Jalankan seluruh regression suite setelah setiap perubahan dan catat kegagalan baru, perbaikan, serta rollback.
- Masukkan kegagalan tools atau konteks yang hilang secara realistis, lalu ukur apakah model dapat pulih tanpa edit berbahaya atau jalan buntu berulang.
- Catat input token, output token, tool call, waktu, retry, dan koreksi reviewer di samping pass rate.
Checklist ini mengubah pertanyaan “apakah coding-nya bagus?” menjadi hasil yang bisa diamati. Tim juga bisa membandingkan Argon, Astra, Opus, atau Sol pada pekerjaan yang sama, tanpa memperlakukan persentase benchmark yang tidak sebanding sebagai hal yang sama.
Arti “benchmaxxing” dalam praktik
Gunakan istilah ini sebagai pertanyaan tentang transfer dari benchmark ke workflow, bukan sebagai vonis tentang training atau kejujuran Argon. Yang bisa dilaporkan adalah benchmark, konfigurasinya, dan keterbatasannya. Pemenang coding harian membutuhkan hasil tugas yang dapat diulang pada workload yang benar-benar dipedulikan pembaca.
Bacaan terkait
Coba Gemma 4 secara online
~/gemma4 $ Coba Gemma 4 di browser sebelum memasangnya di perangkat Anda.
Buka playground Gemma 4 />


