
Claude Opus 5.5 mendapat skor lebih tinggi daripada Gemini 4 Argon pada data Artificial Analysis Intelligence Index tanggal 5 Oktober 2026, dan unggul di tiga dari empat evaluasi detail dalam perbandingan tersebut. Argon unggul di AutomationBench-AA dan memiliki estimasi biaya per tugas yang lebih rendah. Ini adalah tradeoff yang terukur, bukan bukti bahwa salah satu model memiliki spesialisasi software tertentu.
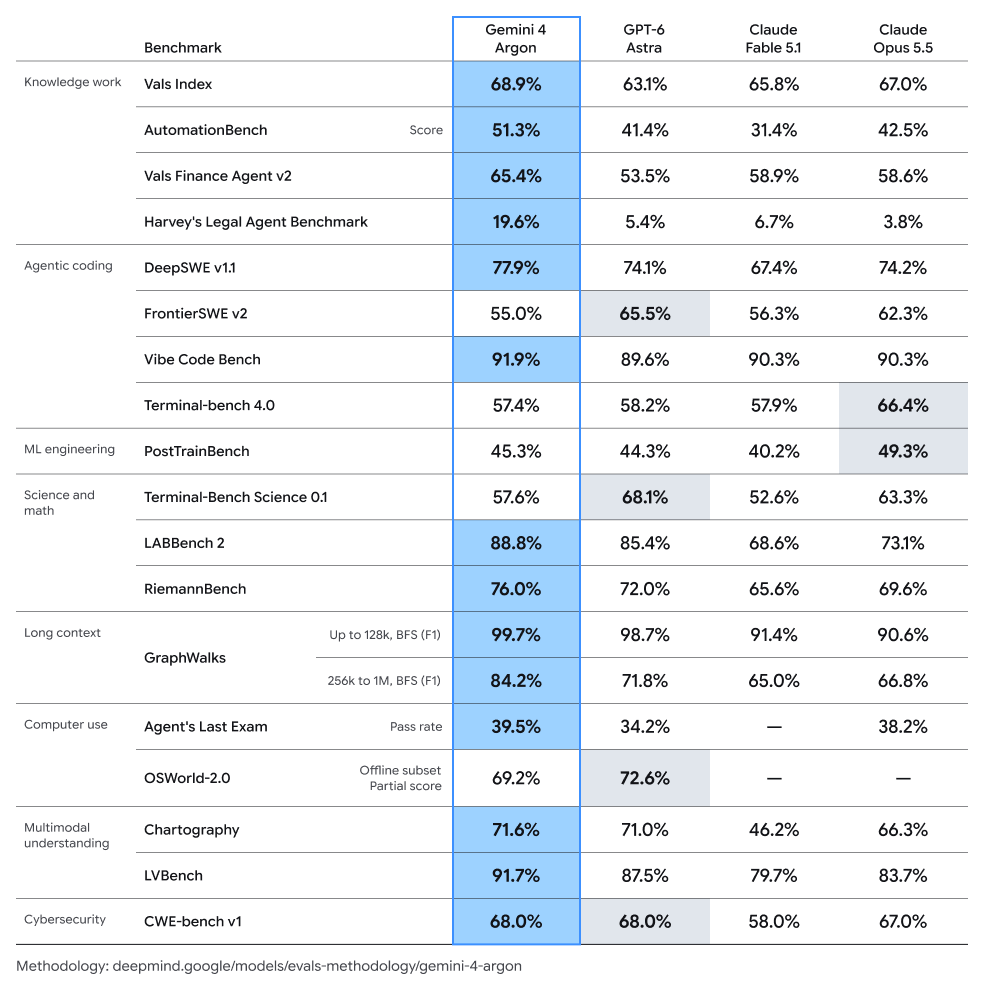
Sumber: Sundar Pichai, 30 September 2026. Pada tabel Google ini, Terminal-bench 4.0 mencatat Argon 57.4% dan Opus 5.5 66.4%, dengan sel Opus diberi arsiran. Astra berada pada 58.2% dan Fable 5.1 pada 57.9% di baris tersebut. Angka-angka ini berbeda dari angka Artificial Analysis Terminal-Bench 4.0 pada tabel di bawah, yaitu 57% dan 60%.
Argon High vs Opus 5.5 sekilas
Perbandingan Artificial Analysis mengevaluasi Gemini 4 Argon High melawan Claude Opus 5.5 Max, Default Fallback. Angka di bawah adalah data per 5 Oktober 2026.
| Evaluasi | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 58 |
| Estimasi biaya per tugas | $1.99 | $5.98 |
| AutomationBench-AA | 78% | 70% |
| Terminal-Bench 4.0 | 57% | 60% |
| GDP.pdf | 22% | 26% |
| AA-LCR v1.1 | 80% | 85% |
Opus unggul 5 poin di indeks, 3 poin di Terminal-Bench 4.0, 4 poin di GDP.pdf, dan 5 poin di AA-LCR v1.1. Argon unggul 8 poin di AutomationBench-AA. Dalam data ini, estimasi per tugas adalah $1.99 untuk Argon dan $5.98 untuk Opus.
Cara membaca perbedaan kecocokan tugas
Tabel ini bisa menjadi titik awal pengujian:
- Gunakan Argon pada workflow yang banyak otomasi jika hasil AutomationBench-AA 78% sesuai dengan tindakan yang dibutuhkan sistemmu.
- Gunakan Opus pada workflow yang membutuhkan eksekusi terminal, penalaran dokumen, atau task family AA-LCR, jika skor lebih tinggi itu sepadan dengan biaya tambahan.
- Ukur pekerjaan yang selesai memakai prompt-mu sendiri. Skor benchmark tidak menetapkan pemenang universal untuk coding harian, pekerjaan antarmuka, atau penulisan panjang.
Konfigurasi yang dievaluasi tidak membenarkan pemberian identitas frontend atau backend kepada kedua model. Akses tools, konteks, tes, dan perilaku retry dapat mengubah hasil praktis.
Harga token berbeda dari biaya per tugas
Perbandingan Artificial Analysis yang sama mencantumkan harga berikut untuk konfigurasi yang dievaluasi:
| Item harga | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Input / output per 1M token | $2 / $10 | $4 / $20 |
| Input cache per 1M token | $0.10 | $0.20 |
Angka per tugas adalah biaya evaluasi berbobot, bukan biaya tetap yang dibayar setiap pelanggan untuk setiap permintaan. Workflow produksi bisa memiliki campuran token, jalur tools, dan panjang output yang berbeda. Gunakan rate card untuk anggaran dan task set yang representatif untuk menghitung unit economics.
Ketersediaan adalah bagian dari perbandingan
Menurut pengumuman Google 30 September, Argon awalnya diberikan kepada pembela siber tepercaya melalui Fairwind dan digunakan secara internal. Rilis lebih luas dimulai dari pelanggan API berbayar dan pelanggan Google AI Ultra. Pengumuman itu tidak menjanjikan tanggal rilis untuk setiap akun. Cek detail akses Argon sebelum membandingkan model yang bisa kamu panggil dengan model yang mungkin masih dibatasi.
Bacaan terkait
Coba Gemma 4 secara online
~/gemma4 $ Coba Gemma 4 di browser sebelum memasangnya di perangkat Anda.
Buka playground Gemma 4 />


