
« Benchmaxxing » est un terme discuté pour désigner un éventuel écart entre les performances sur benchmark et la programmation au quotidien. Les éléments disponibles au 5 octobre 2026 permettent une conclusion plus précise : Gemini 4 Argon obtient de solides résultats publiés, mais ceux-ci ne permettent pas de savoir comment il se comportera sur chaque dépôt ou interface réels.
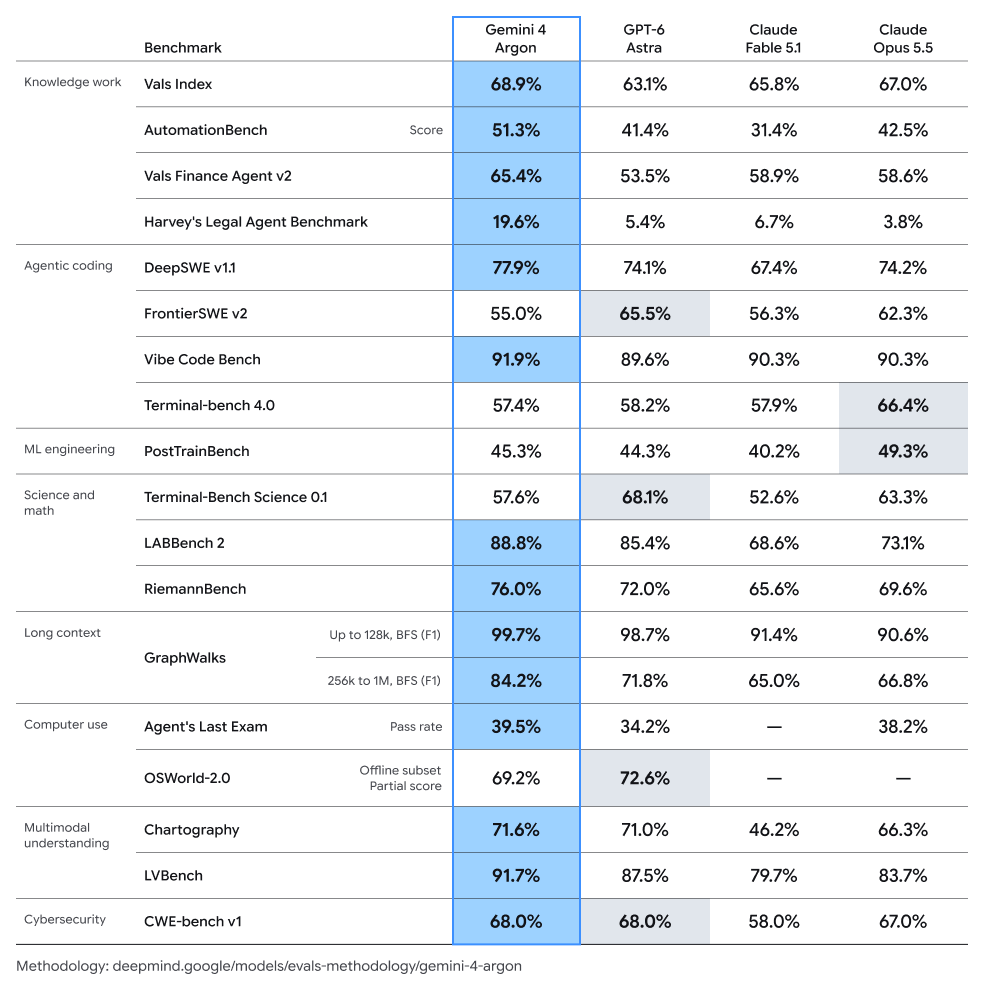
Source : Sundar Pichai, 30 septembre 2026. Les cellules ombrées correspondent aux benchmarks dominés par un autre modèle. FrontierSWE v2 donne 65,5 % à Astra et 55,0 % à Argon. Terminal-bench 4.0 donne 66,4 % à Opus 5.5 et 57,4 % à Argon. DeepSWE v1.1 affiche 77,9 % pour Argon dans le même tableau. Le chiffre de 57 % d’Artificial Analysis dans le tableau suivant est rapporté séparément ; ce n’est pas cette cellule à 57,4 %.
Trois résultats de benchmark, trois questions différentes
Ces résultats doivent rester séparés, car ils mesurent des tâches différentes et proviennent de sources distinctes.
| Source et évaluation | Résultat d’Argon | Ce que cela mesure |
|---|---|---|
| Annonce de Google, DeepSWE v1.1 | 77,9 % | Résultat de Google sur des tâches d’ingénierie logicielle de longue durée |
| Fiche du modèle Artificial Analysis, Terminal-Bench 4.0 | 57 % | Une composante de l’ensemble d’évaluations de l’Intelligence Index d’AA |
| Marqueur FrontierSWE V2, harness proximus | mean@5 de 55,0 % | 34 tâches, cinq essais par tâche et budget de 20 heures |
La page FrontierSWE indique également 65,5 % pour GPT-6 Astra et 62,3 % pour Claude Opus 5.5 dans la même configuration générale. Le score est mean@5 ; les moustaches indiquent les valeurs worst@5 et best@5, et non des intervalles de confiance. FrontierSWE est une évaluation distincte du DeepSWE v1.1 de Google et du Terminal-Bench 4.0 d’Artificial Analysis.
Ce que ces scores établissent et ce qu’ils n’établissent pas
La conclusion pratique est qu’aucune de ces mesures ne constitue un classement du code au quotidien. Elles ne disent pas à quelle fréquence un modèle conserve une interface existante, évite les régressions, se remet d’un appel d’outil échoué ou laisse un dépôt avec ses tests au vert. Un meilleur résultat sur un benchmark peut coexister avec un flux de travail pénible sur une autre tâche.
Les sources primaires disponibles n’établissent pas non plus qu’Argon a été entraîné sur un jeu de test ; cette spéculation ne peut donc pas trancher la question du code.
Tester équitablement Argon dans un flux réel
Lorsque Argon sera disponible pour votre charge de travail, utilisez un jeu d’évaluation fixe qui reflète votre travail réel :
- Commencez avec des dépôts et des tâches qui n’ont pas servi d’exemples dans les prompts, et enregistrez les résultats de référence des tests et du build.
- Incluez des changements d’interface qui nécessitent des contrôles visuels, les comportements au clavier et au pointeur, les états responsives et des vérifications d’accessibilité ; ne jugez pas le code généré par une simple lecture.
- Exécutez toute la suite de non-régression après chaque changement et consignez les nouveaux échecs, les corrections et les retours en arrière.
- Injectez des pannes réalistes d’outils ou un contexte manquant et mesurez si le modèle se rétablit sans modifications dangereuses ni impasses répétées.
- Suivez les tokens d’entrée et de sortie, les appels d’outils, le temps écoulé, les nouvelles tentatives et les corrections du relecteur en parallèle des taux de réussite.
Cette liste transforme « sait-il bien coder ? » en résultats observables. Elle permet aussi à une équipe de comparer Argon à Astra, Opus ou Sol sur le même travail, plutôt que de traiter des pourcentages issus de benchmarks différents comme s’ils étaient interchangeables.
Ce que « benchmaxxing » devrait signifier en pratique
Employez ce terme comme une question sur le transfert d’un benchmark vers un flux de travail, et non comme un verdict sur l’entraînement ou l’honnêteté d’Argon. Les données permettent de présenter le benchmark, sa configuration et ses limites. Pour désigner un champion du code au quotidien, il faut des résultats reproductibles sur les tâches qui intéressent le lecteur.
À lire aussi
Essayez Gemma 4 en ligne
~/gemma4 $ Essayez Gemma 4 dans votre navigateur avant de l’installer sur votre machine.
Essayer Gemma 4 />


