
Claude Opus 5.5 obtient un meilleur score que Gemini 4 Argon dans les données du Artificial Analysis Intelligence Index du 5 octobre 2026, et il arrive en tête de trois des quatre évaluations détaillées de cette comparaison. Argon domine AutomationBench-AA et son coût estimé par tâche est inférieur. C’est un compromis mesurable, qui ne prouve pas pour autant qu’un modèle soit spécialisé dans un domaine logiciel précis.
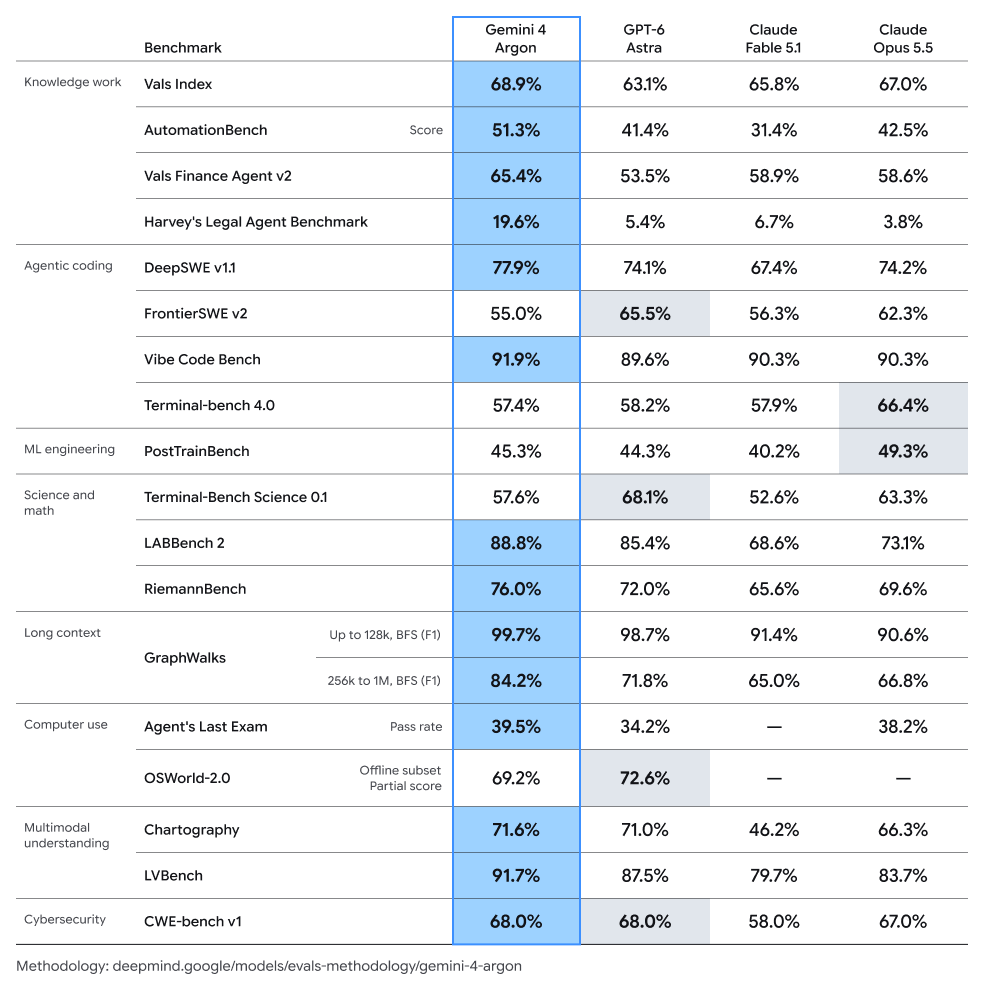
Source : Sundar Pichai, 30 septembre 2026. Dans ce tableau Google, Terminal-bench 4.0 donne 57,4 % à Argon et 66,4 % à Opus 5.5, dont la cellule est ombrée. Astra obtient 58,2 % et Fable 5.1 57,9 % sur cette ligne. Ces pourcentages ne sont pas les chiffres Terminal-Bench 4.0 d’Artificial Analysis indiqués dans le tableau ci-dessous, qui sont de 57 % et 60 %.
Argon High et Opus 5.5 en un coup d’œil
La comparaison d’Artificial Analysis évalue Gemini 4 Argon High face à Claude Opus 5.5 Max, Default Fallback. Les chiffres ci-dessous correspondent aux données publiées le 5 octobre 2026.
| Évaluation | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 58 |
| Coût estimé par tâche | 1,99 $ | 5,98 $ |
| AutomationBench-AA | 78 % | 70 % |
| Terminal-Bench 4.0 | 57 % | 60 % |
| GDP.pdf | 22 % | 26 % |
| AA-LCR v1.1 | 80 % | 85 % |
Opus devance Argon de 5 points sur l’indice, de 3 points sur Terminal-Bench 4.0, de 4 points sur GDP.pdf et de 5 points sur AA-LCR v1.1. Argon devance Opus de 8 points sur AutomationBench-AA. Dans ces données, l’estimation par tâche est de 1,99 $ pour Argon et de 5,98 $ pour Opus.
Comment lire l’écart selon les tâches
Le tableau donne un point de départ pour vos tests :
- Placez Argon sur un flux de travail fortement automatisé si le résultat de 78 % à AutomationBench-AA correspond aux actions dont votre système a besoin.
- Placez Opus sur un flux où l’exécution dans le terminal, le raisonnement documentaire ou la famille de tâches AA-LCR compte, et où ses scores supérieurs justifient le coût supplémentaire.
- Mesurez le travail accompli avec vos propres prompts. Un score de benchmark ne désigne pas un vainqueur universel pour le développement quotidien, les interfaces ou la rédaction longue.
Les configurations évaluées ne justifient pas d’attribuer à ces modèles une identité frontend ou backend. L’accès aux outils, le contexte, les tests et la gestion des tentatives peuvent modifier le résultat en pratique.
Les tarifs au token sont distincts du coût par tâche
La même comparaison d’Artificial Analysis indique les tarifs suivants pour les configurations évaluées :
| Élément tarifaire | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Entrée / sortie par million de tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Entrée en cache par million de tokens | 0,10 $ | 0,20 $ |
Les montants par tâche sont des coûts d’évaluation pondérés, et non des frais fixes que chaque client paie à chaque requête. Une exécution en production peut utiliser un autre mélange de tokens, d’outils et de longueur de réponse. Utilisez la grille tarifaire pour établir votre budget et un ensemble de tâches représentatif pour calculer votre coût unitaire.
La disponibilité compte aussi dans la comparaison
L’annonce de Google du 30 septembre indique qu’Argon est d’abord proposé aux défenseurs cyber de confiance via Fairwind et utilisé en interne, puis que l’élargissement commence avec les clients API payants et les abonnés Google AI Ultra. L’annonce ne promet pas de date de sortie pour chaque compte. Consultez les conditions d’accès à Argon avant de comparer un modèle que vous pouvez appeler à un modèle encore potentiellement limité.
À lire aussi
Essayez Gemma 4 en ligne
~/gemma4 $ Essayez Gemma 4 dans votre navigateur avant de l’installer sur votre machine.
Essayer Gemma 4 />


