
Gemini 4 Argonに単一のベンチマーク順位はありません。Googleの発表表、Artificial Analysisのモデル記録、FrontierSWE V2のリーダーボードは異なるタスクを測り、異なる種類の根拠を示します。以下では、ある評価の結果がすべての評価での勝利として扱われないよう、表を分けています。
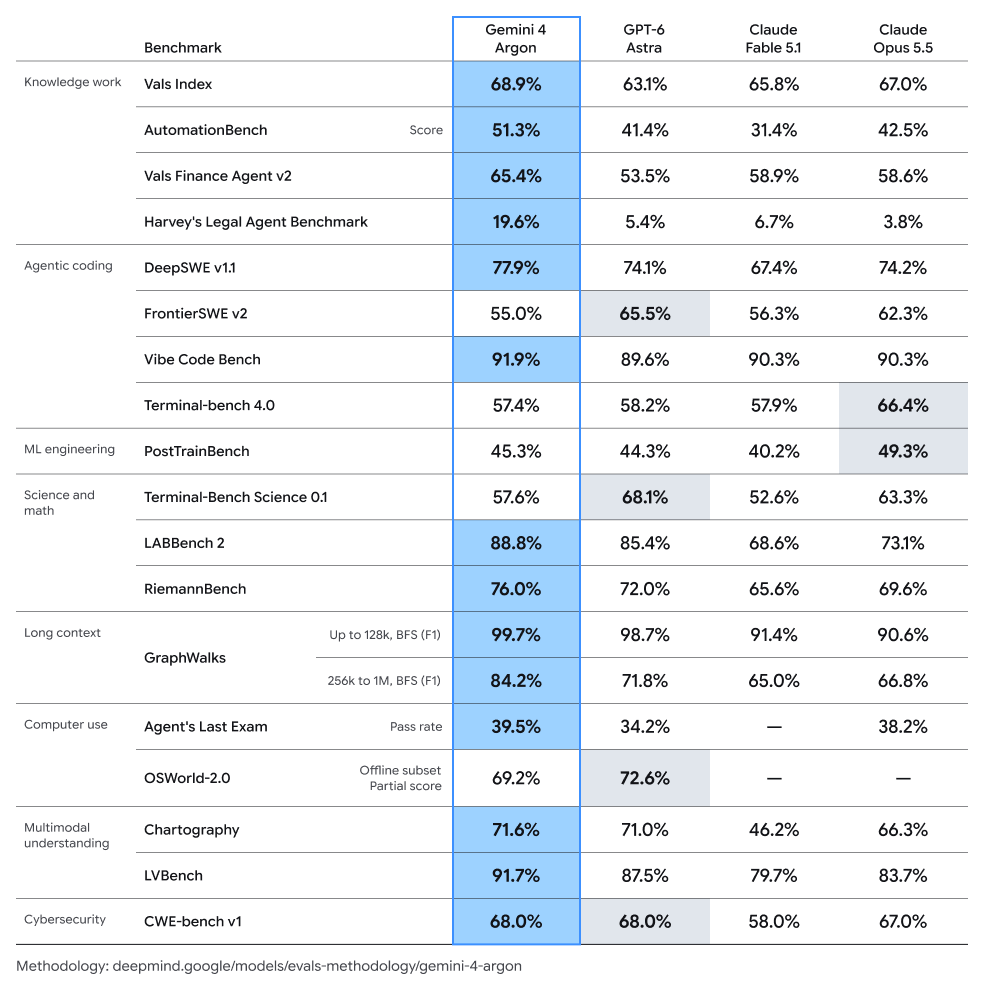
出典: Sundar Pichai、2026年9月30日。この画像はGoogleのローンチ比較表です。網掛けは別のモデルが上回る行を示します。画像に記載された方法論のURLはdeepmind.google/models/evals-methodology/gemini-4-argonです。
Googleの9月30日発表にあるスコア
Googleの発表には、次のスコアが掲載されています。
| 評価 | Argonのスコア | Googleの投稿での説明 |
|---|---|---|
| DeepSWE v1.1 | 77.9% | 長期ソフトウェアエンジニアリングで新たな最高水準 |
| AutomationBench (Zapier) | 51.3% | エンドツーエンドのビジネスタスク実行で1位 |
| LVBench | 91.7% | 長時間動画理解で最高水準 |
| CWE-bench v1 | 68% | セキュリティ脆弱性の修正で1位タイ |
発表記事が取り上げているのは、この4行です。投稿された表には、同じローンチに含まれるより広い結果が載っています。画像では、Vals IndexがArgon 68.9%、Harvey’s Legal Agent Benchmarkが19.6%です。FrontierSWE v2はArgon 55.0%、Astra 65.5%で、Astraのセルが網掛けです。Terminal-bench 4.0はArgon 57.4%、Opus 5.5が66.4%で、Opusのセルが網掛けです。これらは上の画像から読み取った数値で、このページに別のスコアを追加しているわけではありません。
Artificial Analysisのスナップショット
2026年10月5日に確認したArtificial Analysisのモデル記録には、別の概要が掲載されています。
| Artificial Analysisの項目 | スナップショット |
|---|---|
| Intelligence Index v4.3.2 | 53(基礎値52.5606) |
| Intelligence Index 1タスクのコスト | 約$1.99 |
| コンテキストウィンドウ | 1Mトークン |
| アクセス表示 | 一般公開されていない |
Intelligence Indexは複合評価です。その丸めた53を、Googleのタスク別パーセンテージと混ぜてはいけません。タスクコストは評価上の推定値で、顧客に固定請求される料金ではありません。トークン料金はAPI価格と出力上限で確認できます。
FrontierSWE V2:一次情報のコーディングリーダーボード
FrontierSWE V2のリーダーボードは、別のコーディング結果を示します。見出しの表はproximusハーネス、全34タスク、1タスクあたり5試行、20時間の予算で構成されています。スコアはmean@5で、ひげはworst@5からbest@5を示し、信頼区間ではありません。
| モデル | FrontierSWE V2 mean@5 |
|---|---|
| Gemini 4 Argon | 55.0% |
| GPT-6 Astra | 65.5% |
| Claude Opus 5.5 | 62.3% |
この設定では、AstraはArgonを10.5パーセントポイント上回ります。FrontierSWEはDeepSWEでもArtificial Analysis Terminal-Bench 4.0でもありません。そのため、この表だけでGoogleのDeepSWE結果を書き換えたり、普遍的なコーディング順位を決めたりはできません。
サードパーティのText Arenaチャート
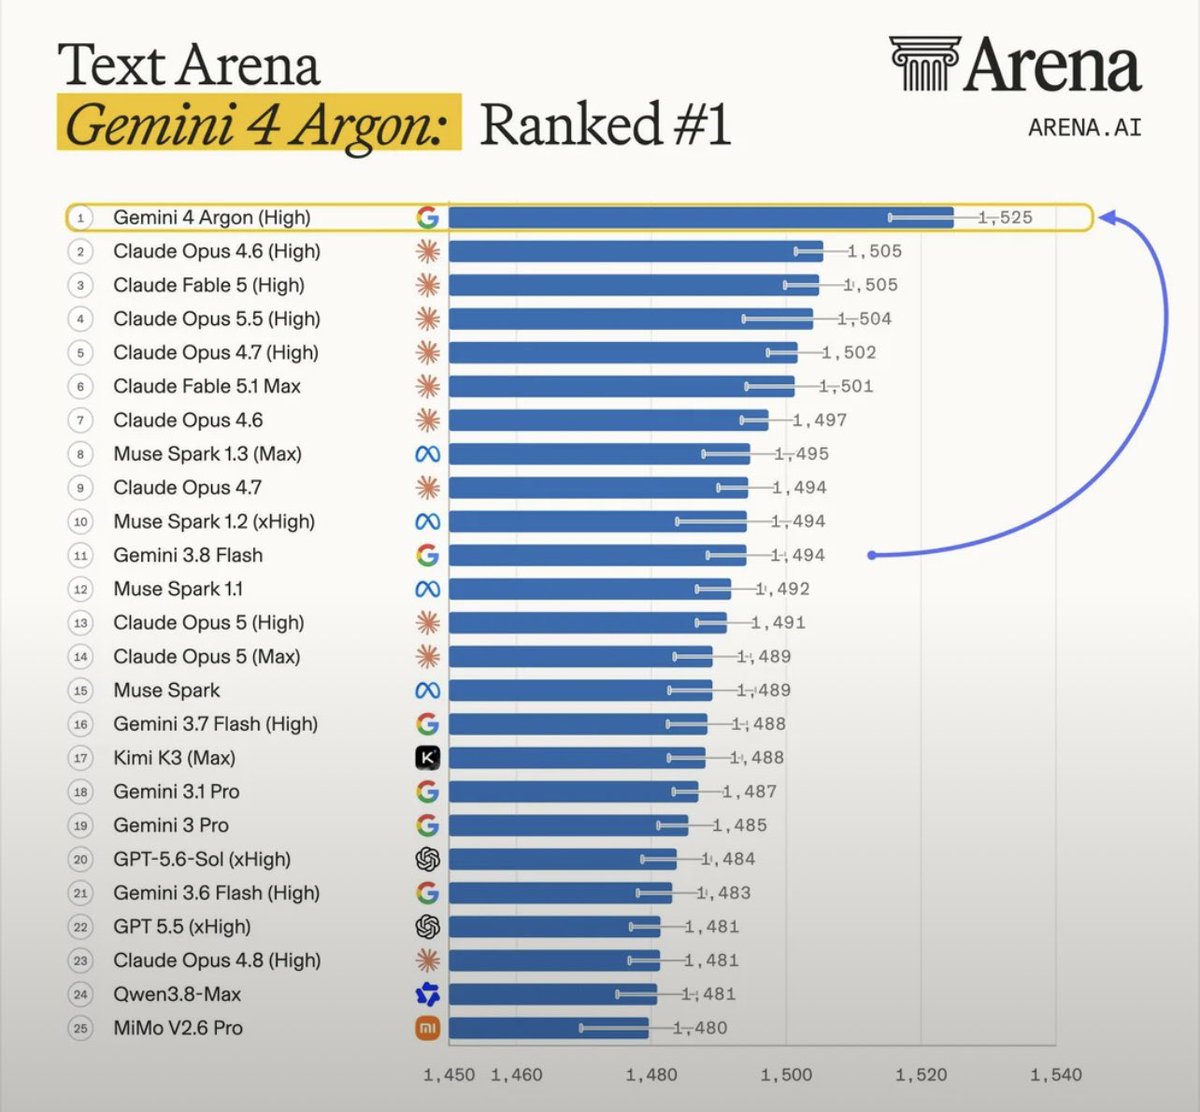
出典: @AI_Screening。これはそのアカウントが投稿したチャートであり、arena.aiのエクスポートではありません。上の3つの表の出典にも含まれません。チャートはGemini 4 Argon(High)をElo 1,525、1位と表示しています。2本目のバーはOpus 5.5ではなくClaude Opus 4.6です。この投稿にある選好リーダーボードの画像として読み取ってください。
数値の差をどう読むか
「Argonが何でも勝つ」という結論より、狭い結論の方が有用です。Argonの報告結果は、タスク、ハーネス、モデル設定、採点ルールによって変わります。別の15.1%というAA-Omniscienceの数値については、ハルシネーション率が測るものを読んでください。ArgonとGemma 4の違いはGemma 4とGeminiの比較で説明しています。


