
ここでいう「ベンチマーク偏重」は、ベンチマークの成績と日常のコーディングの間に差がある可能性を指す、議論のある言葉です。2026年10月5日時点の根拠から言える範囲はもっと狭く、Gemini 4 Argonには強い公開結果がある一方、どのリポジトリやUIでも同じように動くとは証明されていません。
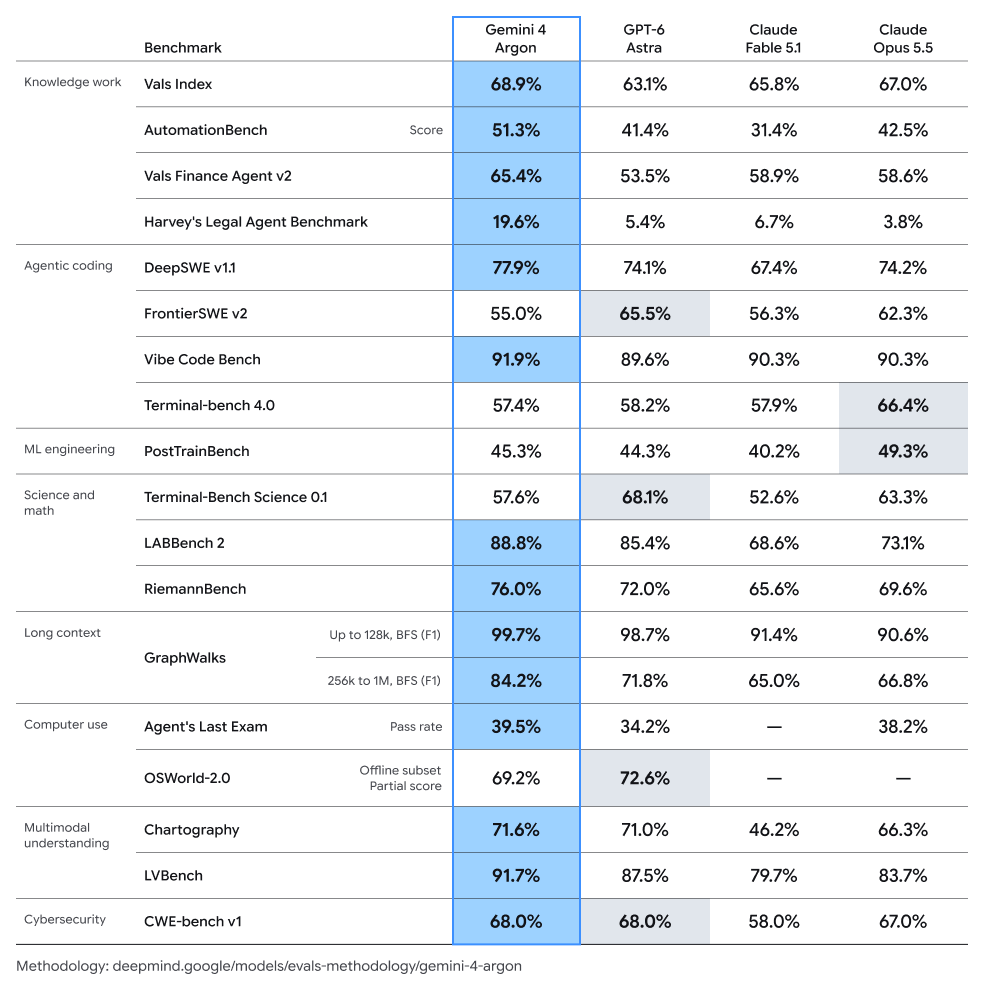
出典: Sundar Pichai、2026年9月30日。網掛けは別のモデルが上回るベンチマークです。FrontierSWE v2はAstra 65.5%、Argon 55.0%です。Terminal-bench 4.0はOpus 5.5が66.4%、Argonが57.4%です。同じ表のDeepSWE v1.1はArgon 77.9%です。次の表にあるArtificial Analysisの57%は別に報告された数値で、この57.4%のセルではありません。
3つのベンチマーク、3つの問い
測るタスクと出典が異なるため、次の結果は分けて扱う必要があります。
| 出典と評価 | Argonの結果 | 測っているもの |
|---|---|---|
| Google発表、DeepSWE v1.1 | 77.9% | Googleが示す長期ソフトウェアエンジニアリングの結果 |
| Artificial Analysisのモデル記録、Terminal-Bench 4.0 | 57% | AA Intelligence Index評価セットの1構成要素 |
| FrontierSWE V2リーダーボード、proximusハーネス | mean@5で55.0% | 34タスク、1タスク5試行、20時間の予算 |
FrontierSWEの同じ見出し設定では、GPT-6 Astraが65.5%、Claude Opus 5.5が62.3%です。スコアはmean@5で、ひげは最悪試行と最良試行を示し、信頼区間ではありません。FrontierSWEはGoogleのDeepSWE v1.1とも、Artificial AnalysisのTerminal-Bench 4.0とも別の評価です。
スコアから分かること、分からないこと
実際の意味は、これらの評価のどれも日常のコーディング順位表ではないということです。既存UIを維持できる頻度、回帰を避けるか、失敗したツール呼び出しから復旧するか、テストが通るリポジトリを残すかは分かりません。あるベンチマークで高い結果でも、別のタスクでは扱いにくいワークフローになる可能性があります。
一次情報からは、Argonがテストセットで訓練されたことも確認できません。その推測だけでコーディングの問いを決めることはできません。
Argonを実ワークフローで公平にテストする方法
Argonを自分のワークロードで使えるようになったら、実際の仕事を反映した固定の評価セットを用意します。
- プロンプト例に使われていないリポジトリとタスクから始め、テストとビルドの基準結果を記録する。
- コードを目視するだけでなく、視覚確認、キーボードとポインター操作、レスポンシブ状態、アクセシビリティが必要なUI変更を含める。
- 変更ごとに回帰テスト一式を実行し、新たな失敗、修正、ロールバックを記録する。
- 現実的なツール障害やコンテキスト不足を入れ、危険な編集や同じ失敗の繰り返しなしに復旧できるか測る。
- 合格率だけでなく、入力・出力トークン、ツール呼び出し、所要時間、リトライ、レビュアーの修正を記録する。
このチェックリストなら、「コーディングが得意か」を観測可能な結果に変えられます。同じ仕事でArgon、Astra、Opus、Solを比べられるため、異なるベンチマークのパーセンテージを同じものとして扱わずに済みます。
「ベンチマーク偏重」を実務でどう使うか
この言葉は、ベンチマークからワークフローへ結果が移るかを問うものとして使い、Argonの訓練や誠実さへの判定として使わないでください。報告すべきなのはベンチマーク、その設定、限界です。日常のコーディングでの勝者には、読者自身の仕事で再現できるタスク結果が必要です。


