
2026年10月5日のArtificial Analysis Intelligence Indexのスナップショットでは、Gemini 4 Argon HighとGPT-6 Astra Maxがともに53です。一方、詳細評価ではArgonがAutomationBench-AA、AstraがTerminal-Bench 4.0、GDP.pdf、AA-LCRで上回ります。タスクあたりの推定コストはArgonの方が低くなっています。これはタスク適性を考える材料ですが、コーディング全般の勝者を証明するものではありません。
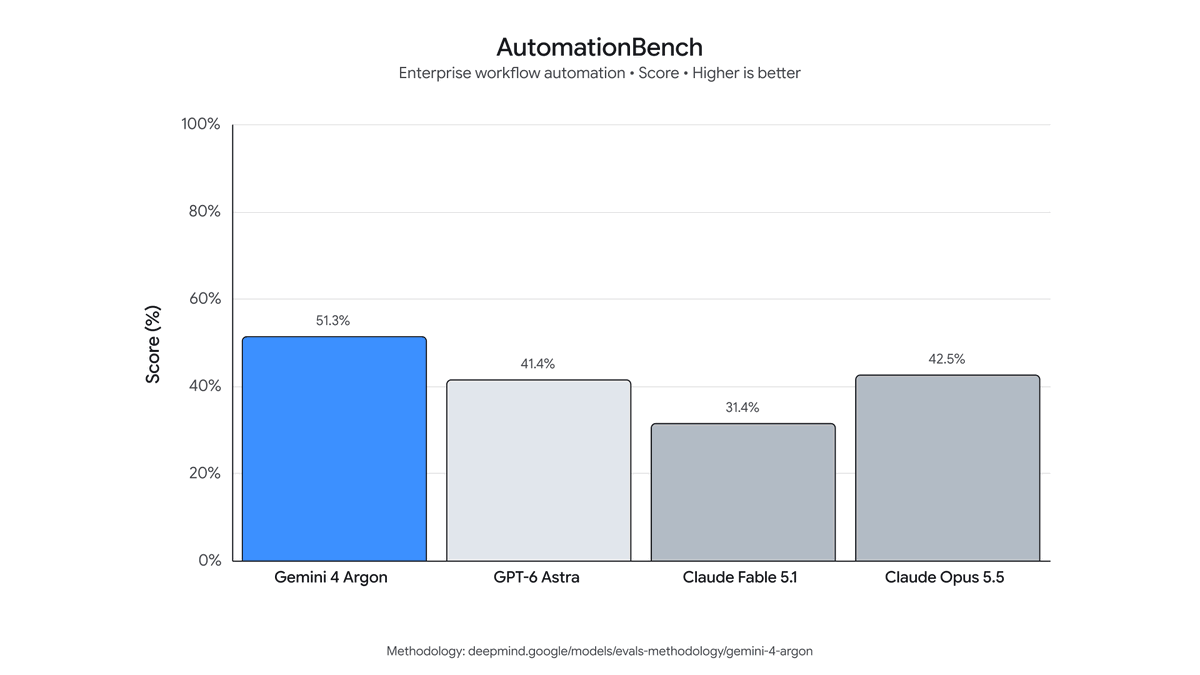
出典: Logan Kilpatrick、Googleの2026年9月30日のローンチチャート。このAutomationBenchの列はArgon 51.3%、Astra 41.4%、Fable 5.1 31.4%、Opus 5.5 42.5%です。Artificial AnalysisのAutomationBench-AAではありません。下の表はAAのスナップショットで、ArgonとAstraは78%と68%です。
Argon HighとAstra Maxの比較
Artificial Analysisの比較ページは、Gemini 4 Argon HighとGPT-6 Astra Maxを使っています。以下は同ページの2026年10月5日のスナップショットで、コストはタスクあたりの評価コスト推定値です。
| 評価 | Gemini 4 Argon High | GPT-6 Astra Max |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 53 |
| タスクあたりの推定コスト | $1.99 | $3.26 |
| AutomationBench-AA | 78% | 68% |
| Terminal-Bench 4.0 | 57% | 59% |
| GDP.pdf | 22% | 31% |
| AA-LCR v1.1 | 80% | 81% |
指数が同じでも、内訳には差があります。AutomationBench-AAではArgonが10ポイント上回ります。Terminal-Bench 4.0ではAstraが2ポイント、GDP.pdfでは9ポイント、AA-LCR v1.1では1ポイント上です。
スコアから考えるタスク適性
以下は評価結果から導く出発点であり、ベンダーが定めた製品の専門分野ではありません。
- エンドツーエンドの自動化が主な評価になるワークフローならArgonを試します。このスナップショットではAutomationBench-AAが78%です。
- ターミナル操作、GDP.pdfで測る文書に基づく推論、AA-LCRのタスク群が中心ならAstraから試します。この3列ではAstraが上です。
- 指数53の同点は、モデルが同じように動く証拠ではありません。タスク単位の結果を確認してください。
これらの数字から、一方をフロントエンドモデル、もう一方をバックエンドモデルと決めることはできません。実際のリポジトリ作業は、プロンプト、ツール、コンテキスト、テスト、失敗からの復旧にも左右されます。契約前に自分のワークロードの小さな評価を行ってください。
トークン料金とタスクコストは別の指標
同じ比較ページには、評価対象の設定について次のトークン料金も記載されています。
| 料金項目 | Gemini 4 Argon High | GPT-6 Astra Max |
|---|---|---|
| 入力 / 出力(1Mトークンあたり) | $2 / $10 | $10 / $50 |
| キャッシュ入力(1Mトークンあたり) | $0.10 | $1.00 |
$1.99と$3.26は重み付きの評価コストであり、すべての顧客リクエストに適用される一律料金ではありません。長いエージェント実行では、指数の計算に使われたタスクとはトークン数やツール利用が異なる場合があります。料金表と、完了タスクあたりの実測コストを両方比べてください。
アクセス状況も実用上の選択を左右する
Googleの9月30日の発表によると、ArgonはまずFairwindの信頼済みサイバー防御担当者と社内利用に提供され、より広い提供は有料APIの顧客とGoogle AI Ultraの購読者から始まります。APIがUltraより先かどうかは示されていません。比較を購入判断に使う前に、現在のArgon公開状況を確認してください。


