
2026年10月5日のArtificial Analysis Intelligence Indexのスナップショットでは、Claude Opus 5.5がGemini 4 Argonより高く、4つの詳細評価のうち3つでも上回ります。ArgonはAutomationBench-AAで上回り、タスクあたりの推定コストも低い結果です。これは測定可能なトレードオフであり、どちらかが特定のソフトウェア分野を独占する証拠ではありません。
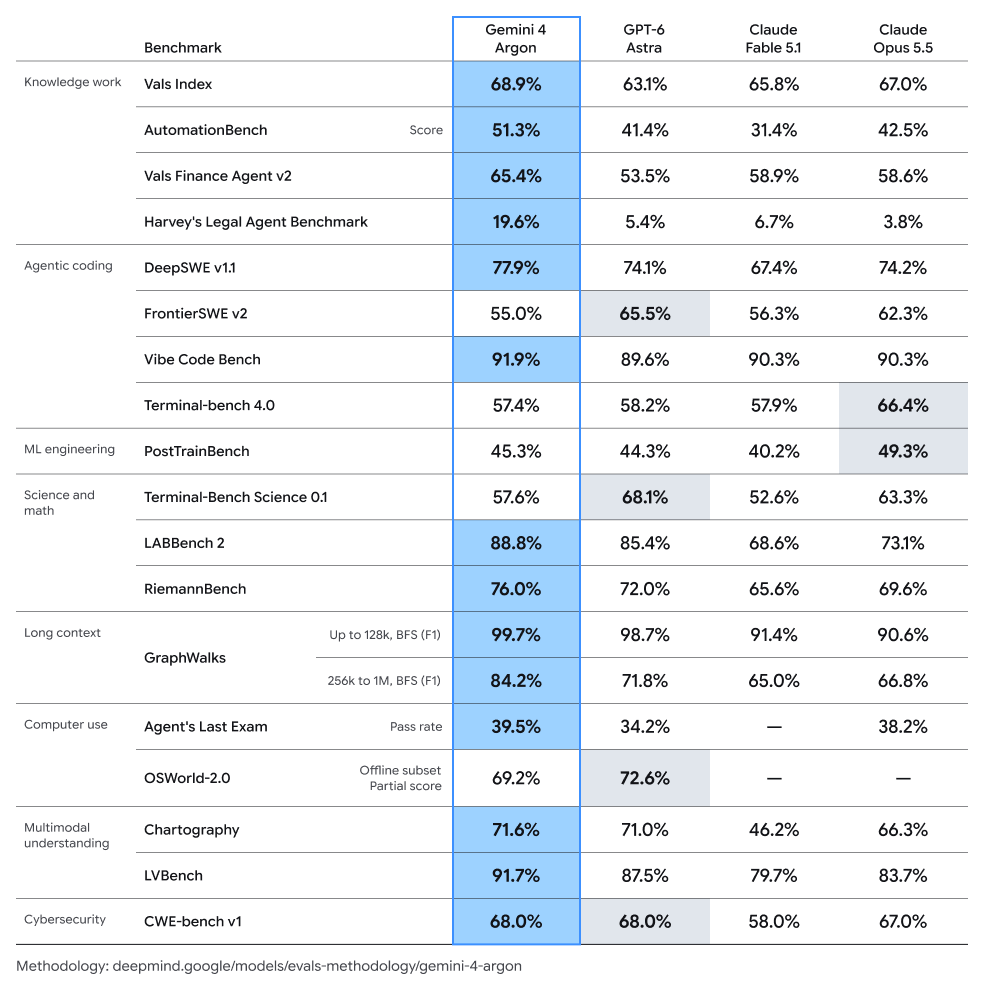
出典: Sundar Pichai、2026年9月30日。このGoogleの表では、Terminal-bench 4.0はArgonが57.4%、Opus 5.5が66.4%で、Opusのセルが網掛けです。同じ行のAstraは58.2%、Fable 5.1は57.9%です。これらは下の表にあるArtificial AnalysisのTerminal-Bench 4.0の数値、57%と60%とは異なります。
Argon HighとOpus 5.5の比較
Artificial Analysisの比較ページは、Gemini 4 Argon HighとClaude Opus 5.5 Max, Default Fallbackを評価しています。以下は2026年10月5日のスナップショットです。
| 評価 | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 58 |
| タスクあたりの推定コスト | $1.99 | $5.98 |
| AutomationBench-AA | 78% | 70% |
| Terminal-Bench 4.0 | 57% | 60% |
| GDP.pdf | 22% | 26% |
| AA-LCR v1.1 | 80% | 85% |
Opusは指数で5ポイント、Terminal-Bench 4.0で3ポイント、GDP.pdfで4ポイント、AA-LCR v1.1で5ポイント上です。ArgonはAutomationBench-AAで8ポイント上回ります。このスナップショットのタスクあたり推定値はArgonが$1.99、Opusが$5.98です。
タスク適性の差をどう読むか
この表はテストの出発点を示します。
- システムに必要な操作がAutomationBench-AAの78%と合うなら、自動化中心のワークフローにArgonを置きます。
- ターミナル操作、文書推論、AA-LCRのタスク群が重要で、追加コストに見合うなら、より高いスコアのOpusを試します。
- 自分のプロンプトで完了した作業を測ってください。ベンチマークスコアは、日々のコーディング、UI作業、長文執筆の普遍的な勝者を決めません。
評価対象の設定から、これらのモデルにフロントエンドやバックエンドという役割を割り当てることはできません。ツール、コンテキスト、テスト、リトライの挙動によって実際の結果は変わります。
トークン料金とタスクコストは別
同じArtificial Analysisの比較には、評価対象の設定について次の料金が掲載されています。
| 料金項目 | Gemini 4 Argon High | Claude Opus 5.5 Max, Default Fallback |
|---|---|---|
| 入力 / 出力(1Mトークンあたり) | $2 / $10 | $4 / $20 |
| キャッシュ入力(1Mトークンあたり) | $0.10 | $0.20 |
タスクあたりの数値は重み付きの評価コストであり、すべての顧客がすべてのリクエストで支払う一律料金ではありません。本番実行では、トークン構成、ツール経路、完了までの長さが異なる場合があります。予算には料金表を、単位経済性には代表的なタスク群を使ってください。
利用可能かどうかも比較の一部
Googleの9月30日の発表によると、ArgonはまずFairwindの信頼済みサイバー防御担当者と社内利用に提供され、より広い提供は有料APIの顧客とGoogle AI Ultraの購読者から始まります。すべてのアカウントへの公開日を約束しているわけではありません。呼び出せるモデルと、まだ制限されている可能性のあるモデルを比べる前に、Argonのアクセス状況を確認してください。


