
Gemini 4 Argon 沒有一個可以概括一切的基準排名。Google 的發布表格、Artificial Analysis 模型紀錄和 FrontierSWE V2 榜單評測的是不同任務,證據類型也不同。下面將成績分表呈現,避免把一項評測的結果說成所有任務上的勝負。
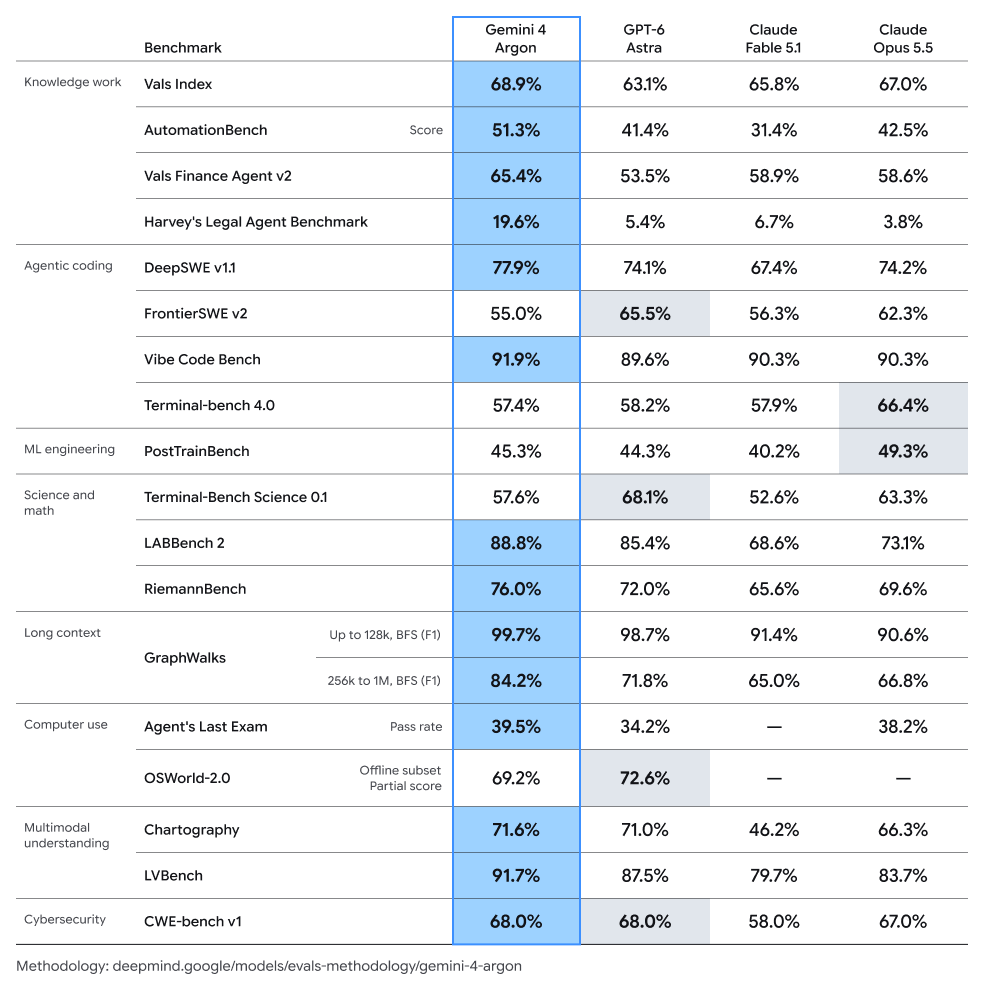
來源:Sundar Pichai,2026 年 9 月 30 日。這是 Google 的發布比較表。陰影儲存格表示該列由另一個模型領先。圖片上印出的評測方法頁面是 deepmind.google/models/evals-methodology/gemini-4-argon。
Google 9 月 30 日表格中的成績
Google 公告報告了以下成績:
| 評測 | Argon 成績 | Google 公告中的說法 |
|---|---|---|
| DeepSWE v1.1 | 77.9% | 長時程軟體工程達到新的最高成績 |
| AutomationBench(Zapier) | 51.3% | 端到端業務任務執行排名第一 |
| LVBench | 91.7% | 長影片理解達到最高成績 |
| CWE-bench v1 | 68% | 修復安全漏洞並列第一 |
公告文章特別列出這四列。發布表格還印出同一場發布中的其他項目。從圖片可見,Argon 的 Vals Index 為 68.9%,Harvey’s Legal Agent Benchmark 為 19.6%。FrontierSWE v2 中 Argon 為 55.0%、Astra 為 65.5%,Astra 的儲存格有陰影。Terminal-bench 4.0 中 Argon 為 57.4%、Opus 5.5 為 66.4%,Opus 的儲存格有陰影。這些數字取自上方圖片,不是本頁另外新增的第二組成績。
Artificial Analysis 資料
2026 年 10 月 5 日查看的 Artificial Analysis 模型紀錄給出了另一組摘要:
| Artificial Analysis 欄位 | 資料 |
|---|---|
| Intelligence Index v4.3.2 | 53(底層值 52.5606) |
| Intelligence Index 單次任務成本 | 約 1.99 美元 |
| 上下文視窗 | 1M Token |
| 存取標記 | 尚未公開提供 |
Intelligence Index 是綜合評測,因此不能把四捨五入後的 53 與 Google 的任務專項百分比合併解讀。單次任務成本是評測估算,不是固定客戶收費。Token 價格見 API 價格與輸出限制。
FrontierSWE V2:主要的程式碼評測榜單
FrontierSWE V2 榜單報告了另一項程式碼評測結果。其主表使用 proximus harness,涵蓋全部 34 個任務,每個任務試驗 5 次,時間預算為 20 小時。成績是 mean@5;鬚線表示 worst@5 到 best@5,並非信賴區間。
| 模型 | FrontierSWE V2 mean@5 |
|---|---|
| Gemini 4 Argon | 55.0% |
| GPT-6 Astra | 65.5% |
| Claude Opus 5.5 | 62.3% |
在這套設定下,Astra 比 Argon 高 10.5 個百分點。FrontierSWE 不是 DeepSWE,也不是 Artificial Analysis Terminal-Bench 4.0,因此這張表不能改寫 Google 的 DeepSWE 結果,也不能建立一個適用所有情境的程式碼排名。
第三方 Text Arena 圖表
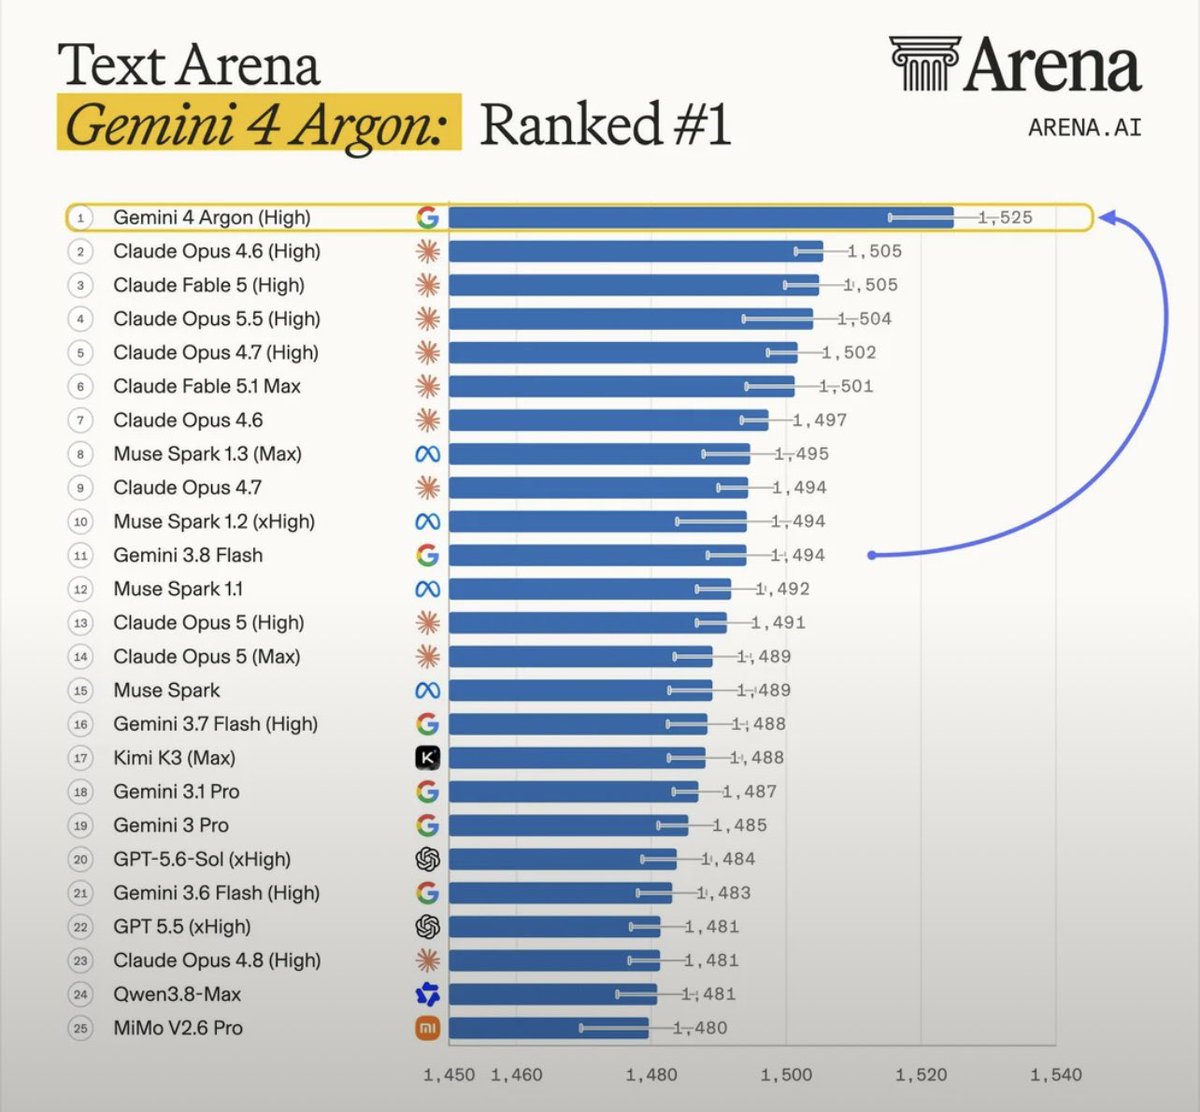
來源:@AI_Screening。這是該帳號發布的圖表,不是 arena.ai 匯出的資料,也不屬於上面三張表使用的三類來源。圖表將 Gemini 4 Argon(High)標為 Elo 1,525、排名第 1。第二根柱形代表 Claude Opus 4.6,不是 Opus 5.5。應把它看作該貼文中的偏好榜圖像。
如何理解這些差距?
更準確的結論不是「Argon 贏下所有評測」。Argon 的成績取決於任務、harness、模型設定和評分規則。15.1% 的 AA-Omniscience 數字請看幻覺率的含義;Argon 與 Gemma 4 的差別請看 Gemma 4 與 Gemini。


