
「基準刷分」(benchmaxxing)是個有爭議的說法,用來描述基準測試表現與日常程式設計之間可能存在的落差。截至 2026 年 10 月 5 日,現有證據支持更保守的結論:Gemini 4 Argon 有很強的公開成績,但這些成績不能說明它在每個真實程式碼儲存庫或介面任務中的表現。
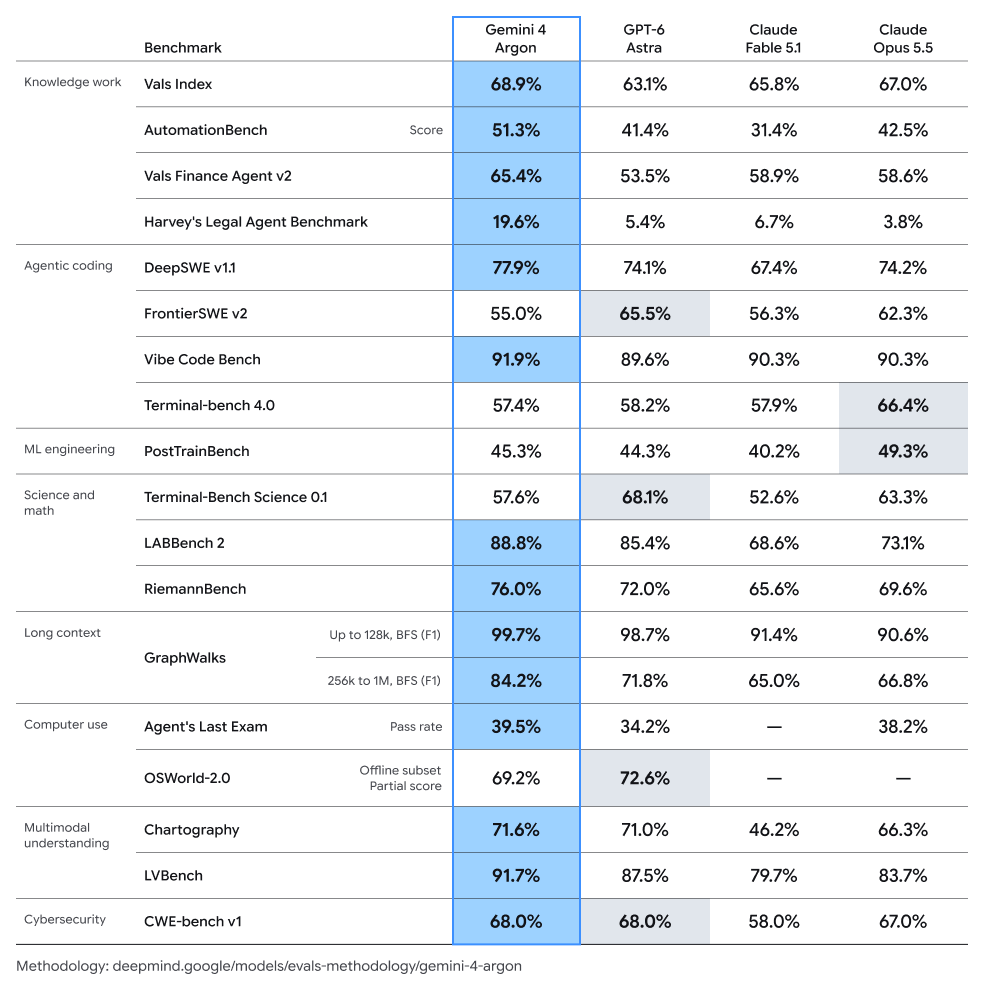
來源:Sundar Pichai,2026 年 9 月 30 日。陰影儲存格表示另一個模型在該項基準測試中領先。FrontierSWE v2 中 Astra 為 65.5%、Argon 為 55.0%;Terminal-bench 4.0 中 Opus 5.5 為 66.4%、Argon 為 57.4%。同一張表中的 DeepSWE v1.1 為 Argon 的 77.9%。下一張表中的 Artificial Analysis 數字為 57%,來源不同,不是這裡的 57.4% 儲存格。
三份基準紀錄,三個不同問題
這些結果應該分開看,因為它們測量的任務不同,來源也不同。
| 來源與評測 | Argon 成績 | 測量內容 |
|---|---|---|
| Google 公告:DeepSWE v1.1 | 77.9% | Google 的長時程軟體工程成績 |
| Artificial Analysis 模型紀錄:Terminal-Bench 4.0 | 57% | AA Intelligence Index 評測集中的一項 |
| FrontierSWE V2 榜單:proximus harness | 55.0% mean@5 | 34 個任務、每項 5 次試驗、20 小時預算 |
在同一套主榜設定下,FrontierSWE 頁面也報告 GPT-6 Astra 為 65.5%,Claude Opus 5.5 為 62.3%。它的成績是 mean@5;鬚線表示最差和最佳試驗結果,並非信賴區間。FrontierSWE 與 Google 的 DeepSWE v1.1、Artificial Analysis 的 Terminal-Bench 4.0 是不同評測。
這些成績能說明什麼,不能說明什麼?
實際結論是:這些指標都不是日常程式設計排行榜。它們不能回答模型多常保留既有 UI、避免回歸、從工具呼叫失敗中恢復,或讓程式碼儲存庫最後通過測試。在某項基準上更高,完全可能與另一類任務中令人挫折的工作流並存。
現有主要來源也沒有證明 Argon 是在測試集上訓練的,因此這種猜測無法解決程式碼能力問題。
如何公平測試 Argon 的真實工作流?
當 Argon 對你的工作負載開放後,可以建立一套固定評測集,反映你實際要做的工作:
- 選擇沒有出現在提示範例中的儲存庫和任務,先記錄基線測試與建置結果。
- 納入需要視覺檢查、鍵盤和指標行為、響應式狀態及無障礙檢查的介面改動,不要只靠檢查生成程式碼來判斷。
- 每次改動後執行完整回歸測試,記錄新增失敗、修正和回滾。
- 注入真實的工具失敗或缺少上下文,測量模型能否在不做危險編輯、不反覆陷入死循環的情況下恢復。
- 除了通過率,也要記錄輸入 Token、輸出 Token、工具呼叫、耗時、重試次數和審閱者修正。
這份清單能把「程式碼寫得好嗎?」轉化成可觀察的結果,也讓團隊可以在同一批工作上比較 Argon、Astra、Opus 或 Sol,而不是把無關的基準百分比當成同一個指標。
實際上應如何使用「基準刷分」這個詞?
把它用作一個關於「基準能否轉移到工作流」的問題,而不是對 Argon 的訓練方式或誠實程度下結論。證據支持報告基準、設定與限制。要稱得上日常程式設計贏家,需要來自讀者關心的工作負載、可重複的任務結果。


