
在截至 2026 年 10 月 5 日的 Artificial Analysis Intelligence Index 資料中,Gemini 4 Argon High 與 GPT-6 Astra Max 都是 53 分。詳細評測則各有領先:Argon 領先 AutomationBench-AA,Astra 領先 Terminal-Bench 4.0、GDP.pdf 和 AA-LCR。Argon 的估算單次任務成本也較低。這些結果提示了不同的適用情境,但不能證明誰是普遍的程式碼贏家。
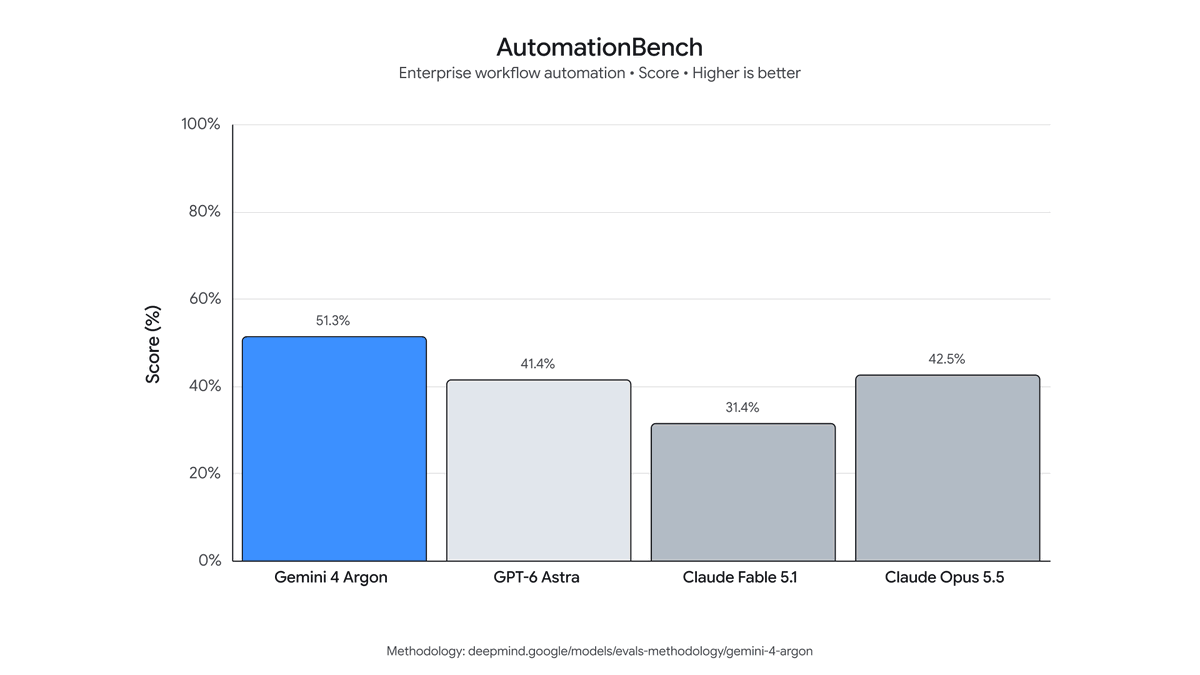
來源:Logan Kilpatrick,圖片來自 Google 9 月 30 日的發布圖表。這一列 AutomationBench 的數值為 Argon 51.3%、Astra 41.4%、Fable 5.1 31.4%、Opus 5.5 42.5%。它不是 Artificial Analysis 的 AutomationBench-AA;下表是 AA 資料,其中 Argon 和 Astra 分別為 78% 和 68%。
Argon High 與 Astra Max 一覽
Artificial Analysis 比較使用 Gemini 4 Argon High 和 GPT-6 Astra Max。下表是該頁面截至 2026 年 10 月 5 日的資料;成本欄是估算的評測單次任務成本。
| 評測 | Gemini 4 Argon High | GPT-6 Astra Max |
|---|---|---|
| Artificial Analysis Intelligence Index | 53 | 53 |
| 估算的單次任務成本 | $1.99 | $3.26 |
| AutomationBench-AA | 78% | 68% |
| Terminal-Bench 4.0 | 57% | 59% |
| GDP.pdf | 22% | 31% |
| AA-LCR v1.1 | 80% | 81% |
相同的指數分數掩蓋了有用的細節。Argon 在 AutomationBench-AA 上高 10 個百分點;Astra 在 Terminal-Bench 4.0 上高 2 分,在 GDP.pdf 上高 9 分,在 AA-LCR v1.1 上高 1 分。
這些成績對適用情境有什麼提示?
以下是基於評測結果的推論,不是廠商替模型指定的產品專長:
- 如果端到端自動化是主要測試,可以選擇 Argon;在這份資料中,它的 AutomationBench-AA 成績為 78%,較高。
- 如果終端執行、以 GDP.pdf 衡量的根據文件進行推理的能力,或 AA-LCR 集合是核心,可以先測試 Astra;它在這三欄都領先。
- 53 分打平時,應查看任務層級結果,而不是據此認定兩個模型行為完全相同。
這些數字不支持「一個模型天生適合前端、另一個天生適合後端」的說法。真實儲存庫工作還取決於提示詞、工具、上下文、測試,以及從失敗操作中恢復的能力。在承諾使用某個供應商前,應先執行自己工作負載的小型版本。
Token 價格與任務成本回答不同問題
同一份比較列出了這些評測配置的 Token 價格:
| 價格項目 | Gemini 4 Argon High | GPT-6 Astra Max |
|---|---|---|
| 每 1M Token 輸入 / 輸出 | $2 / $10 | $10 / $50 |
| 每 1M Token 快取輸入 | $0.10 | $1.00 |
1.99 美元和 3.26 美元是加權評測成本,不是每位客戶每次請求都要支付的固定費用。長時間執行的代理可能使用與計算指數的任務不同數量的 Token 和工具。應同時比較價格表和自己測得的每個已完成任務成本。
可用性仍會影響實際選擇
Google 的 9 月 30 日公告表示,Argon 首先提供給 Fairwind 中的可信網路安全防禦人員並供內部使用,之後從付費 API 客戶和 Google AI Ultra 訂閱者開始擴大存取。公告沒有說明 API 是否先於 Ultra。在把這份基準比較當成購買決定前,請查看目前 Argon 發布詳情。


